からだにいいもの
Rで解析:重なったプロットを整えて見せる「vayr」パッケージの紹介
実験や調査の結果を散布図にすると、同じ座標に多数のデータが重なり、点の密度も群ごとの違いも読み取れなくなることがあります。しかし、重なりを解くために点をずらす場合、ずらす範囲や並べ方を目的に合わせて組み立てるには手間がかかります。
「vayr」パッケージは、ggplot2の位置調整として使える一連の関数を提供します。重なった点を楕円の範囲に散らす調整、点の間隔を均した乱れによる調整、ひまわりの種・円充填・六角格子といった規則的な並びへ置き換える調整が収録されています。
また、ランダム化実験で結果が欠測した場合に、取りうる値の下限と上限で補完し、効果の幅を示すデータを作ることも可能です。本パッケージの利用で、重なったデータを損なわずに示し、結果の読み取りを助けることができるのではないかと考えます。
パッケージバージョンは1.1.0。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
パッケージのインストール
下記コマンドを実行してください。
# パッケージのインストール
install.packages("vayr")

# パッケージの読み込み
library("vayr")

# コマンド例実行で必要なパッケージを読み込み
# install.packages("ggplot2")
library("ggplot2")コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
同じ座標に複数のデータが置かれ、個々の点が見分けられなくなった状態を、重複プロット(over-plotted points)と呼びます。5段階や7段階の評価、処置の有無といった、値の種類が少ない変数を散布図にすると起こりやすくなります。
以降のコマンド例では、次の擬似データを共通して使います。
# 乱数の種を固定
set.seed(1129)

# 来店者数を設定
n_kyaku <- 240

# 直売所で行った売り場実験を想定した擬似データを作成
# 品種を3つ用意し、説明POPを出すかどうかを来店者へランダムに割り当てる
naoshi <- data.frame(
  hinshu = rep(c("えびす", "みやこ", "くりゆたか"), each = n_kyaku / 3),
  hyoji  = sample(rep(c("POPなし", "POPあり"), each = n_kyaku / 2)))

# 品種と説明POPの有無から購入意向を作り、7段階の整数に丸める
naoshi$hyouka <- pmin(7, pmax(1, round(
  4 + 0.6 * (naoshi$hyoji == "POPあり") +
    0.5 * (naoshi$hinshu == "えびす") + rnorm(n_kyaku, 0, 1.2))))

# 試食に出したかぼちゃ1個あたりの重さ(kg)を作成
naoshi$omosa <- round(runif(n_kyaku, 1.2, 2.8), 2)
重なった点を楕円の範囲に散らす:position_jitter_ellipseコマンド
重なった点を、指定した楕円の範囲へランダムに散らします。ggplot2のposition_jitterは長方形の範囲に散らすため、四隅まで点が張り出し、群の境目が角張って見えます。楕円にすると、ひとかたまりの散らばりとして見えます。
| オプション | 意味 | 初期値 |
|---|---|---|
| width | 重なった点を散らす楕円領域の横幅 | NULL |
| height | 重なった点を散らす楕円領域の高さ | NULL |
| seed | 再現性のための乱数の種 | NA |
# 説明POPの有無ごとに、購入意向の7段階評価を描画
# 楕円の範囲に散らして、同じ評価に集まった点の量を見えるようにする
ggplot(naoshi, aes(x = hyoji, y = hyouka)) +
  geom_point(position = position_jitter_ellipse(width = 0.35, height = 0.35,
                                                seed = 1129),
             alpha = 0.5) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)")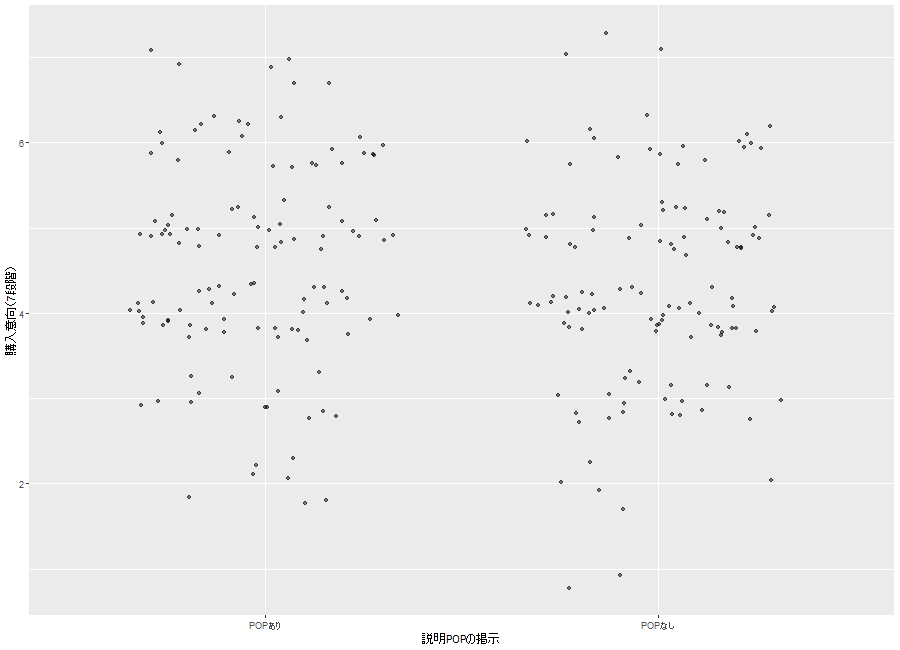
楕円の範囲に散らしつつグループをずらす:position_jitterdodge_ellipseコマンド
楕円の範囲への散らしに、群ごとの横ずらしを加えます。色分けした群が同じ位置に重なったままでは、どの群の点が多いのか判断できません。dodge.widthで群同士を離してから散らします。
| オプション | 意味 | 初期値 |
|---|---|---|
| jitter.width | 重なった点を散らす楕円領域の横幅 | NULL |
| jitter.height | 重なった点を散らす楕円領域の高さ | NULL |
| dodge.width | 群をずらす幅 | 1 |
| seed | 再現性のための乱数の種 | NA |
| orientation | 群を分ける軸。”x” は左右、”y” は上下。ggplot2::position_dodge() の同名引数に対応する | “x” |
# 説明POPの有無を横軸に取り、品種ごとに色と形を変えて描画
# 品種を左右にずらしてから、それぞれを楕円の範囲に散らす
ggplot(naoshi, aes(x = hyoji, y = hyouka, color = hinshu, shape = hinshu)) +
  geom_point(position = position_jitterdodge_ellipse(jitter.width = 0.2,
                                                     jitter.height = 0.3,
                                                     dodge.width = 0.8,
                                                     seed = 1129)) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)",
       color = "品種", shape = "品種")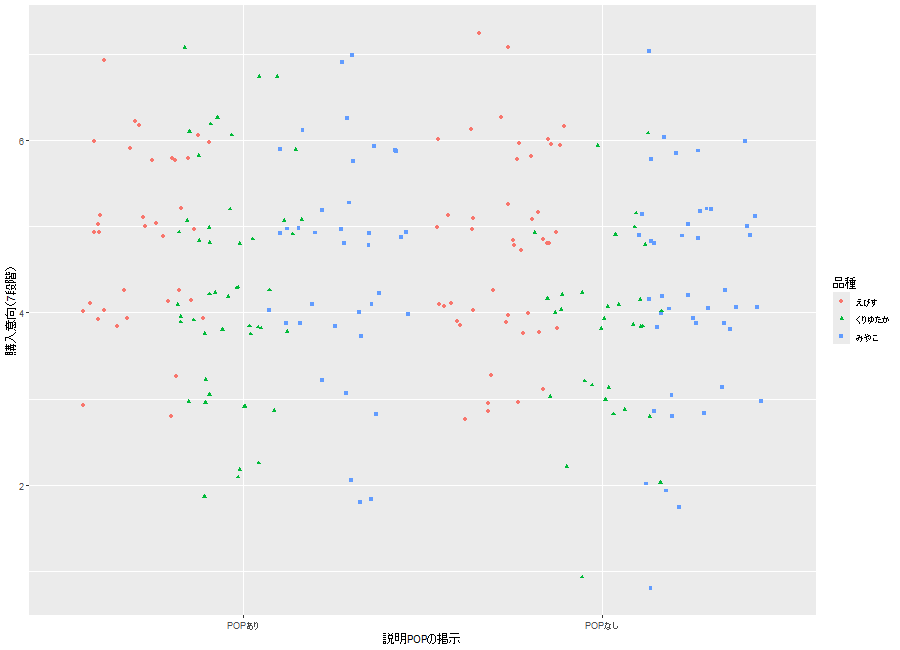
間隔を均した乱れで重なりを解く:position_bluenoiseコマンド
楕円の範囲へ点を散らしますが、点同士の間隔ができるだけ均等になるように配置します。単純な乱数では、たまたま点が固まる場所と空く場所ができます。candidatesで指定した数だけ候補を引き、既にある点から最も離れた候補を採用することで、この偏りを抑えます。
| オプション | 意味 | 初期値 |
|---|---|---|
| width | 点を散らす楕円領域の横幅 | NULL |
| height | 点を散らす楕円領域の高さ | NULL |
| candidates | 1点あたりに検討する乱数の候補数。大きいほど点の間隔が均等になり、計算に時間がかかる。既定の10で、点が固まる現象はほぼ解消する | 10 |
| seed | 再現性のための乱数の種 | NA |
# 候補数を既定の10から20へ増やし、点の間隔をより均等にして描画
ggplot(naoshi, aes(x = hyoji, y = hyouka)) +
  geom_point(position = position_bluenoise(width = 0.35, height = 0.35,
                                           candidates = 20, seed = 1129)) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)")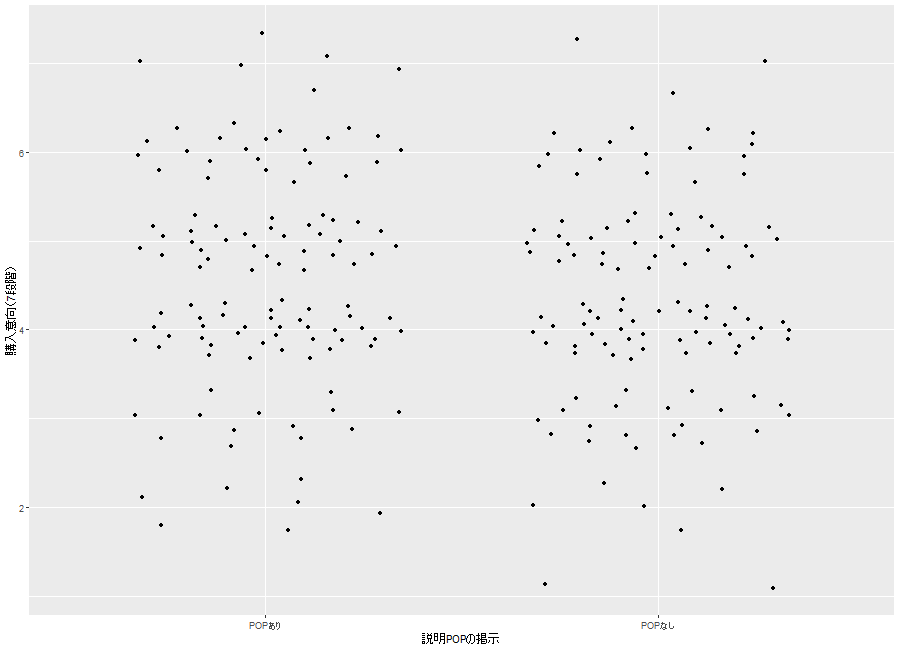
間隔を均した乱れとグループのずらしを重ねる:position_bluenoisedodgeコマンド
間隔を均した散らしに、群ごとのずらしを加えます。散らす範囲の指定がscatter.width・scatter.heightという名前になり、ずらし幅のdodge.widthと区別されます。
| オプション | 意味 | 初期値 |
|---|---|---|
| scatter.width | 点を散らす楕円領域の横幅 | NULL |
| scatter.height | 点を散らす楕円領域の高さ | NULL |
| dodge.width | 群をずらす幅 | 1 |
| candidates | 1点あたりに検討する乱数の候補数 | 10 |
| seed | 再現性のための乱数の種 | NA |
| orientation | 群を分ける軸。”x” は左右、”y” は上下。ggplot2::position_dodge() の同名引数に対応する | “x” |
# 品種ごとに色を変え、群を左右へずらしたうえで間隔を均して散らす
ggplot(naoshi, aes(x = hyoji, y = hyouka, color = hinshu)) +
  geom_point(position = position_bluenoisedodge(scatter.width = 0.2,
                                                scatter.height = 0.3,
                                                dodge.width = 0.8,
                                                candidates = 20,
                                                seed = 1129)) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)", color = "品種")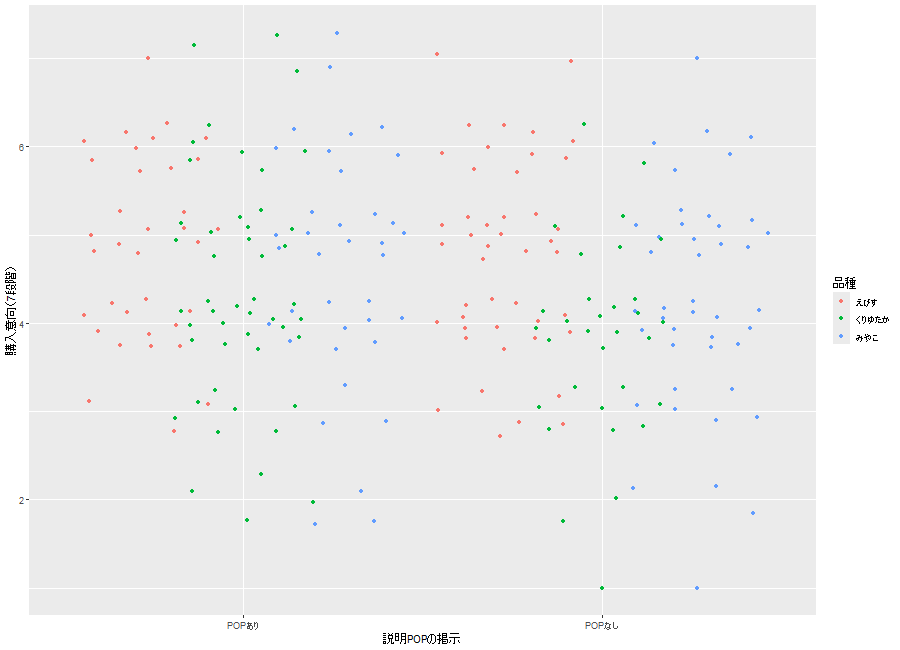
重なった点をひまわりの種の並びに配置する:position_sunflowerコマンド
ここからは乱数を使わず、規則的な図形へ並べ替える調整です。本コマンドは、同じ座標に重なった点を、ひまわりの種のような渦巻きの並びに置き換えます。乱数を使わないため、同じデータからは常に同じ図が得られます。densityは並びの詰まり具合で、軸の範囲や図の大きさに応じて調整します。
| オプション | 意味 | 初期値 |
|---|---|---|
| density | 配置パターンの密度。既定は 1 だが、多くの場合は調整が必要になる。適切な密度は軸の範囲と図の大きさによって変わる | 1 |
| aspect_ratio | coord_equal() を使わない場合に生じる、円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要なら既定の 1 でよい。coord_fixed() を使う場合は、その ratio 引数と同じ値にする | 1 |
# 同じ評価に集まった点を、ひまわりの種の並びに置き換えて描画
# 乱数を使わないため、実行のたびに同じ配置になる
ggplot(naoshi, aes(x = hyoji, y = hyouka)) +
  geom_point(position = position_sunflower(density = 8), size = 1.2) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)")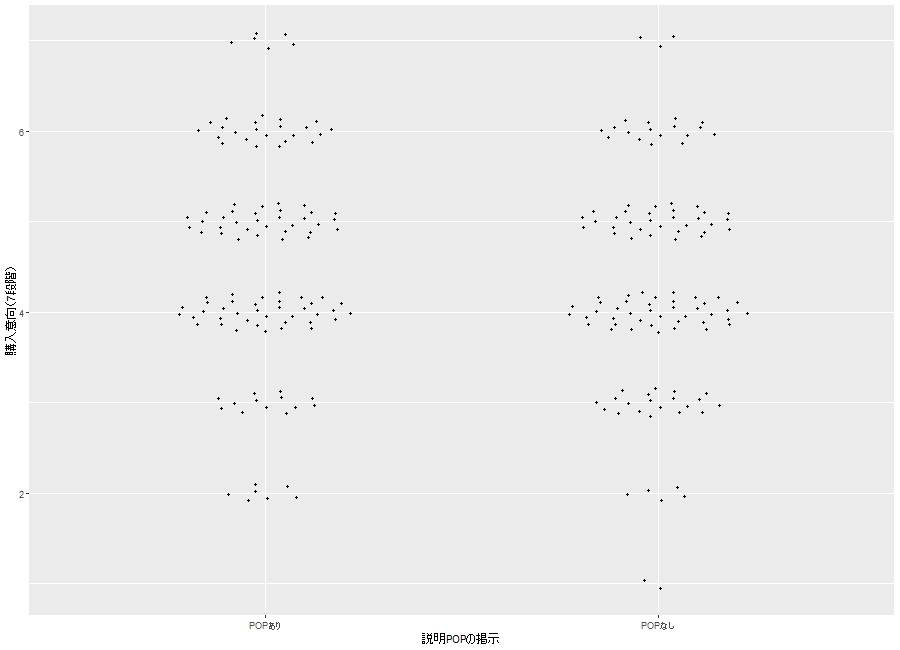
ひまわりの並びとグループのずらしを重ねる:position_sunflowerdodgeコマンド
ひまわりの種の並びに、群ごとのずらしを加えます。群を離してから並べるため、渦巻きが群の数だけ横に並びます。ずらした分だけ1つあたりの幅が狭くなるので、densityは単独で使うときより大きめにします。
| オプション | 意味 | 初期値 |
|---|---|---|
| width | 群をずらす幅 | 1 |
| density | 配置パターンの密度。既定は 1 だが、多くの場合は調整が必要になる。適切な密度は軸の範囲と図の大きさによって変わる | 1 |
| aspect_ratio | coord_equal() を使わない場合に生じる、円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要なら既定の 1 でよい。coord_fixed() を使う場合は、その ratio 引数と同じ値にする | 1 |
| orientation | 群を分ける軸。”x” は左右、”y” は上下。ggplot2::position_dodge() の同名引数に対応する | “x” |
# 品種ごとに渦巻きを分けて、評価の分布を並べて見る
# ずらしで幅が狭くなる分、密度を単独利用より大きくする
ggplot(naoshi, aes(x = hyoji, y = hyouka, color = hinshu)) +
  geom_point(position = position_sunflowerdodge(width = 0.8, density = 14),
             size = 1.2) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)", color = "品種")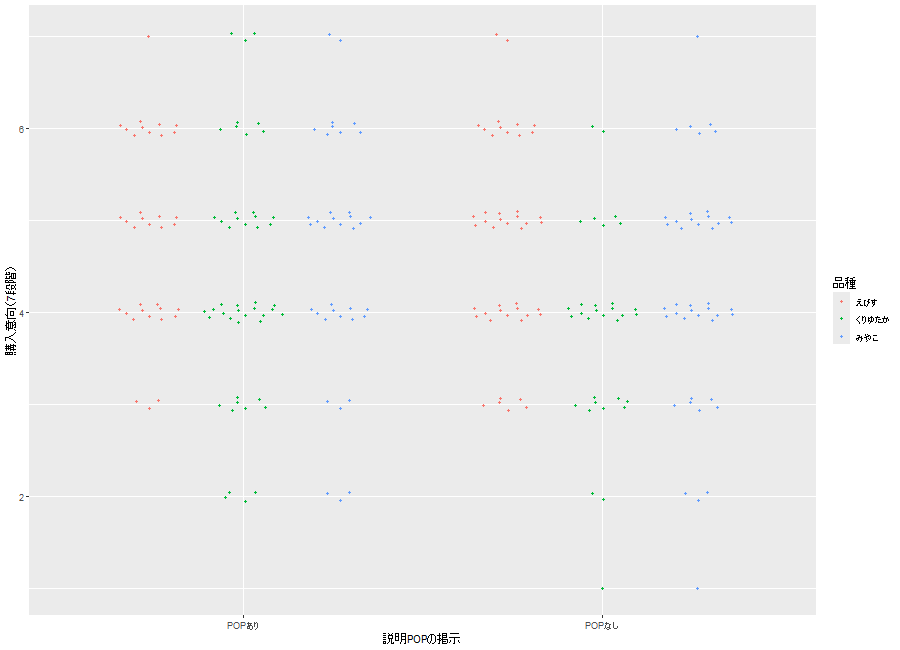


大きさの異なる点を円充填で並べる:position_circlepackコマンド
重なった点を、互いに触れ合うように詰めて配置します。点ごとに大きさが違う場合でも重ならないように詰めるため、sizeに重みや量を割り当てた図に向きます。他の調整と違い、点の大きさそのものが配置に影響します。
| オプション | 意味 | 初期値 |
|---|---|---|
| density | 円充填の密度。既定は 1 だが、多くの場合は調整が必要になる。適切な密度は軸の範囲・図の大きさ・サイズスケールによって変わる | 1 |
| aspect_ratio | coord_equal() を使わない場合に生じる、円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要なら既定の 1 でよい。coord_fixed() を使う場合は、その ratio 引数と同じ値にする | 1 |
# かぼちゃ1個あたりの重さを点の大きさに割り当てて描画
# 大きさの異なる円が重ならないように詰めて配置する
ggplot(naoshi, aes(x = hyoji, y = hyouka, size = omosa)) +
  geom_point(position = position_circlepack(density = 6), alpha = 0.4) +
  scale_size_continuous(range = c(1, 4)) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)", size = "重さ(kg)")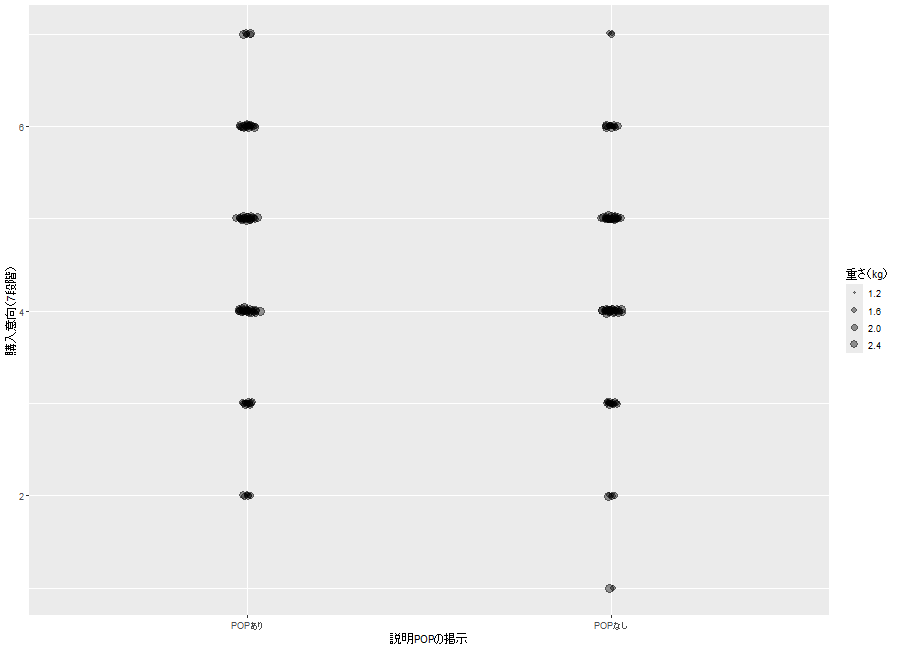
円充填とグループのずらしを重ねる:position_circlepackdodgeコマンド
円充填の配置に、群ごとのずらしを加えます。重みの大きさの違いを保ったまま、群ごとの塊を分けて見比べられます。
| オプション | 意味 | 初期値 |
|---|---|---|
| width | 群をずらす幅 | 1 |
| density | 円充填の密度。既定は 1 だが、多くの場合は調整が必要になる。適切な密度は軸の範囲・図の大きさ・サイズスケールによって変わる | 1 |
| aspect_ratio | coord_equal() を使わない場合に生じる、円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要なら既定の 1 でよい。coord_fixed() を使う場合は、その ratio 引数と同じ値にする | 1 |
| orientation | 群を分ける軸。”x” は左右、”y” は上下。ggplot2::position_dodge() の同名引数に対応する | “x” |
# 品種ごとに塊を分け、重さを大きさに割り当てて詰めて配置
ggplot(naoshi, aes(x = hyoji, y = hyouka, size = omosa, color = hinshu)) +
  geom_point(position = position_circlepackdodge(width = 0.8, density = 12),
             alpha = 0.4) +
  scale_size_continuous(range = c(1, 3)) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)",
       size = "重さ(kg)", color = "品種")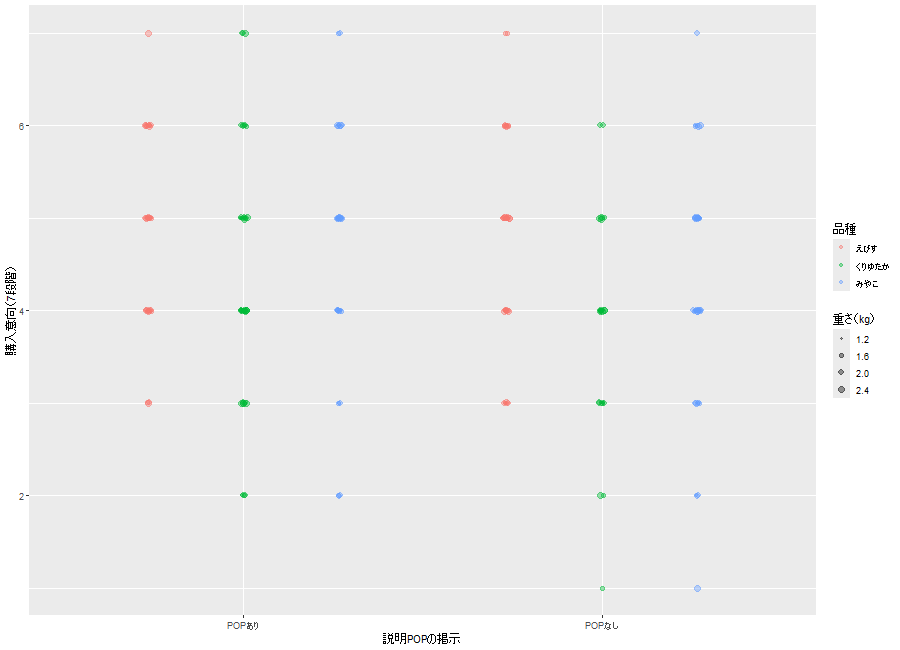
重なった点を六角格子に並べる:position_honeycombコマンド
重なった点を、蜂の巣状の六角格子に並べます。行と列が揃うため、点の数の違いが塊の面積として比べやすくなります。同じ大きさの点を数えて見せたい場合は、円充填よりこちらが向きます。
| オプション | 意味 | 初期値 |
|---|---|---|
| density | 配置パターンの密度。既定は 1 だが、多くの場合は調整が必要になる。適切な密度は軸の範囲と図の大きさによって変わる | 1 |
| aspect_ratio | coord_equal() を使わない場合に生じる、円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要なら既定の 1 でよい。coord_fixed() を使う場合は、その ratio 引数と同じ値にする | 1 |
# 同じ評価に集まった点を六角格子に並べ、塊の大きさで人数を比べる
ggplot(naoshi, aes(x = hyoji, y = hyouka)) +
  geom_point(position = position_honeycomb(density = 8), size = 1.2) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)")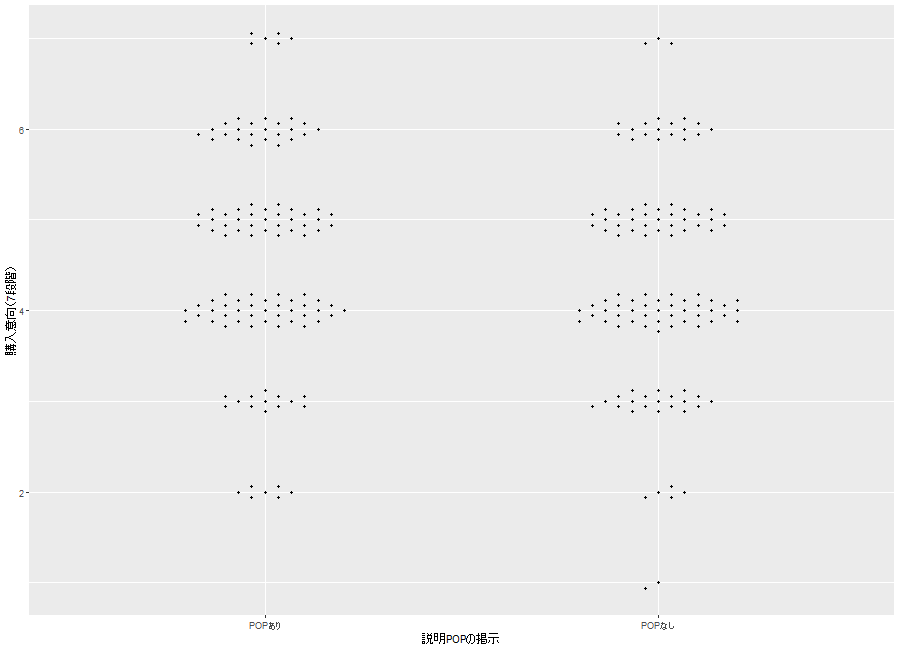
六角格子への配置とグループのずらしを重ねる:position_honeycombdodgeコマンド
六角格子への配置に、群ごとのずらしを加えます。群ごとの塊が横に並ぶため、同じ評価を選んだ人数の差が見て取れます。
| オプション | 意味 | 初期値 |
|---|---|---|
| width | 群をずらす幅 | 1 |
| density | 配置パターンの密度。既定は 1 だが、多くの場合は調整が必要になる。適切な密度は軸の範囲と図の大きさによって変わる | 1 |
| aspect_ratio | coord_equal() を使わない場合に生じる、円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要なら既定の 1 でよい。coord_fixed() を使う場合は、その ratio 引数と同じ値にする | 1 |
| orientation | 群を分ける軸。”x” は左右、”y” は上下。ggplot2::position_dodge() の同名引数に対応する | “x” |
# 品種ごとに六角格子の塊を分けて、評価ごとの人数を見比べる
ggplot(naoshi, aes(x = hyoji, y = hyouka, color = hinshu, shape = hinshu)) +
  geom_point(position = position_honeycombdodge(width = 0.8, density = 14),
             size = 1.2) +
  labs(x = "説明POPの掲示", y = "購入意向(7段階)",
       color = "品種", shape = "品種")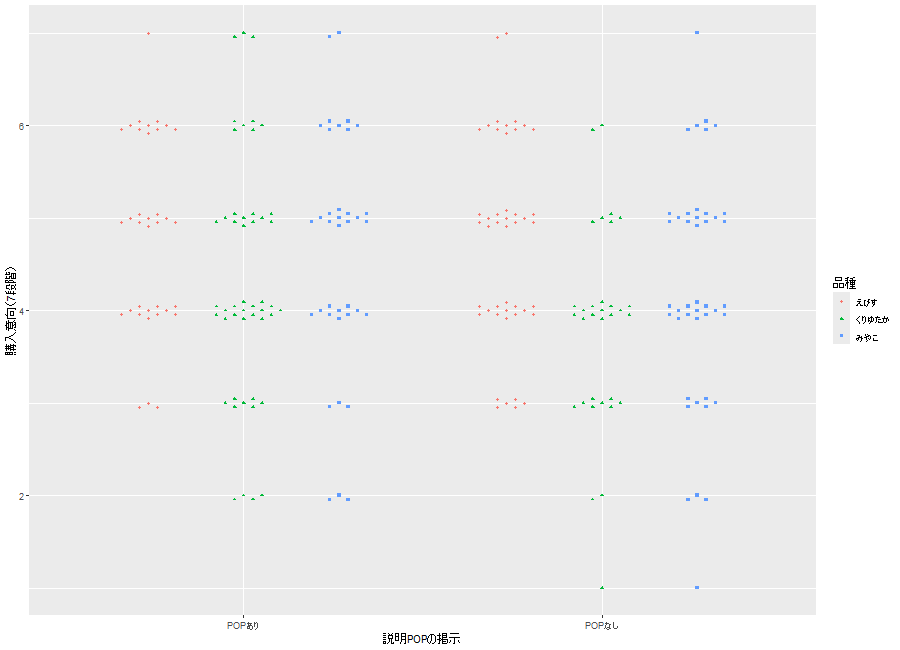
ひまわり配置の座標を直接計算する:sunflowerコマンド
position_sunflowerの内部で使われている計算そのものを呼び出します。重なった点の座標を渡すと、ずらした後の座標が返ります。x軸とy軸を一度に扱うのではなく、xを渡せばx座標、yを渡せばy座標だけが返る点に注意してください。両方の座標が必要な場合は、2回に分けて呼び出します。要素が1つだけのベクトルは、重なりがないものとしてそのまま返ります。
| オプション | 意味 | 初期値 |
|---|---|---|
| x | 重なった複数の点が共有するx座標のベクトル。長さ1のときは、重なりがないものとしてそのまま返る | NULL |
| y | 重なった複数の点が共有するy座標のベクトル。長さ1のときは、重なりがないものとしてそのまま返る | NULL |
| density | 配置パターンの密度 | なし |
| aspect_ratio | 円形配置のゆがみを補正する縦横比。縦に伸びるゆがみには 2 のような大きい値、横に伸びるゆがみには 0.5 のような小さい値を与える。補正が不要な場合は 1 にする | なし |
# 座標 (2, 5) にちょうど7人分が重なっている状況を想定
# ずらした後のx座標を求める
x_zurashi <- sunflower(x = rep(2, 7), density = 8, aspect_ratio = 1)
# 同じ7点について、ずらした後のy座標を求める
y_zurashi <- sunflower(y = rep(5, 7), density = 8, aspect_ratio = 1)
# 求めた座標を並べて確認
data.frame(x = round(x_zurashi, 3), y = round(y_zurashi, 3))
      x     y
1 1.976 5.022
2 2.005 4.943
3 2.057 5.074
4 1.908 4.984
5 2.079 4.950
6 1.976 5.090
7 1.957 4.917
欠測を極値で補って効果の範囲を求める:impute_extreme_valuesコマンド
ランダム化した実験で回答が得られなかった人がいる場合に、結果が取りうる下限と上限のそれぞれで欠測を埋めたデータを作ります。処置群に最小値・対照群に最大値を入れた場合と、その逆の場合の2通りを縦に積んだデータフレームが返り、行数は元の2倍になります。どちらの向きで埋めたかはscenario列、埋めた行かどうかはimputed列で区別できます。欠測の埋め方によって効果がどこまで動きうるかを示すために使います。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | 結果変数と割り当て変数を含むデータフレーム | なし |
| outcome | 結果変数の列名を表す文字列。数値の列であり、その欠測値が補完の対象になる | なし |
| assignment | ランダム割り当ての列名を表す文字列。値はちょうど2種類で、欠測があってはならない | なし |
| range | 結果変数が論理的に取りうる最小値と最大値を並べた長さ2の数値ベクトル。7段階のリッカート尺度であれば c(1, 7) になる | なし |
| treated | 処置群を表す assignment の値。既定では並べ替え順で2番目の値が使われ、c(“Control”, “Treatment”) なら “Treatment”、c(0, 1) なら 1 になる。並べ替え順で処置群を選べない場合に明示する | NULL |
# 回答を得られなかった来店者がいる状況を作る
naoshi_kesson <- naoshi
naoshi_kesson$hyouka[c(3, 12, 60, 137)] <- NA

# 評価の下限1と上限7で欠測を埋め、効果の取りうる幅を作る
# 日本語の並べ替え順に頼らないよう、処置群の値を明示する
kekka <- impute_extreme_values(naoshi_kesson, "hyouka", "hyoji",
                               range = c(1, 7), treated = "POPあり")

# 実際に埋められた行だけを取り出して確認
kekka[kekka$imputed == "Outcome imputed", ]
    hinshu   hyoji hyouka omosa    scenario         imputed
3   えびす POPなし      7  1.37 Lower bound Outcome imputed
12  えびす POPなし      7  1.38 Lower bound Outcome imputed
60  えびす POPあり      1  2.23 Lower bound Outcome imputed
137 みやこ POPあり      1  2.30 Lower bound Outcome imputed
243 えびす POPなし      1  1.37 Upper bound Outcome imputed
252 えびす POPなし      1  1.38 Upper bound Outcome imputed
300 えびす POPあり      7  2.23 Upper bound Outcome imputed
377 みやこ POPあり      7  2.30 Upper bound Outcome imputed
2通りの埋め方それぞれで平均を取ると、説明POPの効果がどの範囲に収まるかが分かります。
# 埋め方の向きと説明POPの有無ごとに、購入意向の平均を求める
aggregate(hyouka ~ scenario + hyoji, data = kekka, FUN = mean)
     scenario   hyoji   hyouka
1 Lower bound POPあり 4.508333
2 Upper bound POPあり 4.608333
3 Lower bound POPなし 4.366667
4 Upper bound POPなし 4.266667
下限側では 4.508333 – 4.366667 = 0.141666、上限側では 4.608333 – 4.266667 = 0.341666 となります。欠測をどう埋めるかによって、説明POPの効果はこの幅の中で動くと読み取れます。
この記事が誰かの役に立ちますように。