からだにいいもの
Rで解析:音韻カテゴリーの分離・重なりを複数指標で評価する「phontrast」パッケージの紹介
音声学や言語学の研究では、母音や子音といった音韻カテゴリーが、フォルマント値やMFCCなどの音響空間上でどれだけ明確に区別されているかを確認したい場面があります。しかし、複数の指標を一括で計算し、話者やグループごとのばらつきを考慮しながら評価するには手間がかかります。
「phontrast」パッケージは、多次元の音響空間における2つのカテゴリー間の分離度や重なり具合を、複数の指標を用いて一括で算出するパッケージです。Pillaiのトレースや Bhattacharyya 距離、Jensen-Shannon 情報量など複数の指標をまとめて計算でき、話者単位の階層ブートストラップによる年齢効果の検定も可能です。また、算出結果にもとづくカテゴリー空間の可視化や、主成分分析による高次元特徴量の投影図のプロットも可能です。本パッケージの利用で、音韻のコントラストを複数の指標から多角的に確認できるのではないかと考えます。
パッケージバージョンは2.4.0。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>
パッケージのインストール
下記コマンドを実行してください。
# パッケージのインストール
install.packages("phontrast")
# パッケージの読み込み
library("phontrast")コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
本パッケージの中心となるのはphontrastコマンドで、2つの音韻カテゴリーについてPillaiのトレースやBhattacharyya距離、Jensen-Shannon情報量など複数の分離・重なり指標を一括で算出します。話者ごとの経年変化を調べたい場合はhier_boot_jsd_modelコマンドで階層ブートストラップモデルを当てはめられます。また、plot_contrastコマンドやplot_category_spaceコマンド、plot_category_pcaコマンドでカテゴリー間の分布を可視化でき、plot_overlap_metricsコマンドで複数の比較対象の指標をまとめて確認できます。配色にはphontrast_paletteコマンドとscale_colour_phontrastコマンドが用意されています。
本記事では、京都市右京区と与謝郡伊根町の高校生が発音した母音「い」「え」のフォルマント測定値を架空のデータとして作成し、記事全体を通して使用します。
# 乱数シードの固定
set.seed(2026)

# 右京区と伊根町の話者情報を作成
chiku <- rep(c("右京区", "伊根町"), each = 4)

wakate <- data.frame(
  speaker = paste0("sp", sprintf("%02d", 1:8)),
  chiku = chiku,
  age = rep(c(16, 17, 18, 17), 2)
)

# 話者ごとに「い」「え」を25回ずつ発音したデータの骨組みを作成
boin <- data.frame(
  speaker = rep(wakate$speaker, each = 50),
  vowel = rep(rep(c("い", "え"), each = 25), nrow(wakate))
)

# 話者情報を結合
boin <- merge(boin, wakate, by = "speaker", sort = FALSE)

# 母音と地区の違いを反映した第1フォルマント(F1)を生成
boin$f1 <- rnorm(nrow(boin),
                 mean = ifelse(boin$vowel == "い", 320, 480) +
                   ifelse(boin$chiku == "伊根町", 25, 0),
                 sd = 45)

# 母音と地区の違いを反映した第2フォルマント(F2)を生成
boin$f2 <- rnorm(nrow(boin),
                 mean = ifelse(boin$vowel == "い", 2400, 2050) +
                   ifelse(boin$chiku == "伊根町", -110, 0),
                 sd = 140)

# 第3フォルマント(F3)を生成
boin$f3 <- rnorm(nrow(boin), mean = ifelse(boin$vowel == "い", 3000, 2900), sd = 150)
# スペクトル傾動を生成

boin$tilt <- rnorm(nrow(boin),
                   mean = ifelse(boin$vowel == "い", -8, -5) +
                     ifelse(boin$chiku == "伊根町", -1, 0),
                   sd = 2)
2つのカテゴリー間の分離・重なりを複数指標で算出:phontrastコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| data | カテゴリを表す列と音響特徴量の列を含むデータフレーム | なし |
| features | 数値の特徴量列を指定する文字列ベクトル | なし |
| category_col | 比較する2つのカテゴリーが入った列名の文字列 | なし |
| group_col | グループ化に使う列を指定する文字列ベクトル(複数可)。NULLなら全体で算出し、複数指定時はラベルを結合して扱う | NULL |
| metrics | 算出する指標を選ぶ文字列ベクトル。jsd、js_distance、pillai、bhattacharyya、mahalanobis、overlapから選択でき、既定はすべて。bhattacharyyaはバタチャリヤ距離と近似度の両方を返す | c(“jsd”, “js_distance”, “pillai”, “bhattacharyya”, “mahalanobis”, “overlap”) |
| min_tokens | 全体またはグループごとに必要な最小トークン数 | 20 |
| bw | jsd_kde_nd()とpercent_overlap_kde()に渡すバンド幅選択法 | c(“Hpi”, “Hscv”, “Hpi.diag”, “scott.diag”) |
| eval_on | jsd_kde_nd()とpercent_overlap_kde()に渡すKDE評価点の位置 | c(“pooled”, “group1”, “group2”, “pooled_sample”) |
| eval_n | KDE評価点数の上限 | NULL |
| eval_seed | KDE評価点のサブサンプリングに使う整数のシード | NULL |
| engine | KDE評価エンジン。fast_diagonalはfast_diagの別名として扱われる | c(“ks”, “fast_diag”, “fast_diagonal”) |
| chunk_size | engine = “fast_diag”のときのチャンクサイズ | 1000L |
| eps | 共分散にもとづく指標に用いる小さなリッジ定数 | 1e-06 |
| output | 出力形式。wideは比較ごとに1行、longは指標ごとに1行にまとめる | c(“wide”, “long”) |
| do_boot | 論理値。TRUEならブートストラップで各指標の平均・標準偏差・信頼区間を算出 | FALSE |
| n_boot | do_boot = TRUEのときのブートストラップ再標本化の回数 | 1000 |
| conf_level | ブートストラップ信頼区間の信頼水準 | 0.95 |
| progress | 論理値。TRUEならブートストラップの実行中に進捗メッセージを表示 | TRUE |
| method | jsdと重なり率の列に用いるKDE推定法。mc(既定)はモンテカルロのプラグイン推定、legacyは1.2.0より前の自己正規化推定。density = “mvnorm”のときは無視される | c(“mc”, “legacy”) |
| density | Jensen-Shannon情報量と比率重なりの2指標が前提とする密度モデル。kde(既定)はカーネル密度推定、mvnormは各カテゴリーに多変量正規分布を当てはめモンテカルロ法で推定する。Pillai・Bhattacharyya・Mahalanobisの列はこの引数の影響を受けない | c(“kde”, “mvnorm”) |
| mc_n | density = “mvnorm”のとき、Jensen-Shannon情報量と重なり率のために各正規分布から抽出するモンテカルロ標本数 | 10000L |
2つの音韻カテゴリーに含まれる音響特徴量から、Pillaiのトレース、Bhattacharyya距離・近似度、Jensen-Shannon情報量とその平方根であるJensen-Shannon距離、Mahalanobis距離、比率重なりの各指標を一括で算出します。metricsで算出する指標を絞り込め、group_colを指定するとグループごとに算出できます。outputを”long”にすると指標ごとに1行の縦持ち形式になり、後述のplotコマンドやplot_overlap_metricsコマンドにそのまま渡せます。
# 右京区・伊根町の母音「い」「え」の分離度をまとめて算出(全列を表示)
print(phontrast(boin, features = c("f1", "f2"), category_col = "vowel"), width = Inf)
# A tibble: 1 × 10
  scope  n_tokens pillai pillai_p_value bhatt_dist bhatt_affinity   jsd
  <chr>     <int>  <dbl>          <dbl>      <dbl>          <dbl> <dbl>
1 global      400  0.814      8.44e-146       2.18          0.113 0.950
  js_distance mahalanobis_dist percent_overlap
        <dbl>            <dbl>           <dbl>
1       0.975             4.18          0.0238
話者ごとの階層ブートストラップでJensen-Shannon情報量の年齢依存性をモデル化:hier_boot_jsd_modelコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| data | group_col、category_col、features、および式で使う説明変数を含むデータフレーム | なし |
| group_col | グループ化変数を表す列名の文字列(例:speaker) | なし |
| category_col | 2水準を持つカテゴリー変数を表す列名の文字列(例:vowel) | なし |
| features | 音響特徴量の列名を表す文字列ベクトル | なし |
| formula | fit_funに渡すモデル式(例:jsd_beta ~ s(age) + s(region, bs = “re”)) | なし |
| fit_fun | (formula, data, …)を受け取り当てはめ済みモデルを返す関数。既定はmgcv::gamが使えればそれ、なければstats::lm | NULL |
| n_outer | 階層ブートストラップの再標本化回数 | 200 |
| min_tokens | グループ内で必要な最小トークン数 | 20 |
| eps | Beta族を使う場合にJSDを(0, 1)へ収めるための小さなイプシロン | 1e-06 |
| progress | 論理値。TRUEなら10回ごとに進捗を表示 | TRUE |
| … | fit_funに渡す追加の引数 | なし |
話者をグループとしてリサンプリングしながら、話者ごとのJensen-Shannon情報量にformulaで指定したモデルを繰り返し当てはめます。戻り値は再標本化ごとの回帰係数の一覧で、係数のばらつきから年齢の効果の確からしさを確認できます。
# 乱数シードの固定
set.seed(2026)
# 話者ごとのJensen-Shannon情報量に年齢を説明変数とした回帰を階層ブートストラップで当てはめ
hier_boot_jsd_model(
  data = boin,
  group_col = "speaker",
  category_col = "vowel",
  features = "f1",
  formula = jsd_beta ~ age,
  fit_fun = stats::lm,
  n_outer = 5,
  min_tokens = 20,
  progress = FALSE
)
# A tibble: 10 × 3
   boot_id term        estimate
     <int> <chr>          <dbl>
 1       1 (Intercept)   0.584
 2       1 age           0.0226
 3       2 (Intercept)   1.81
 4       2 age          -0.0514
 5       3 (Intercept)   1.76
 6       3 age          -0.0506
 7       4 (Intercept)   1.13
 8       4 age          -0.0137
 9       5 (Intercept)   2.15
10       5 age          -0.0710
2つのカテゴリー間の分布を考慮した対比図のプロット:plot_contrastコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| data | カテゴリを表す列と1〜2個の数値特徴量列を含むデータフレーム | なし |
| features | 1〜2個の数値特徴量列。1個なら密度曲線、2個なら密度領域を伴う特徴量空間の図になる。3次元以上を扱う場合はplot_category_pca()で射影する(指標自体は全次元で算出する) | なし |
| category_col | 観測されたカテゴリーがちょうど2種類だけ入った列名の文字列 | なし |
| group_col | 任意で指定する文字列ベクトルのグループ化列。グループごとに1パネル、グループ単位の密度と注釈を表示 | NULL |
| density | 描画・注釈に使う密度モデル。kde(既定)またはmvnorm。指標関数のdensity引数に対応 | c(“kde”, “mvnorm”) |
| bw | density = “kde”のときのバンド幅選択法。jsd_kde_nd()と同じ選択肢 | c(“Hpi”, “Hscv”, “Hpi.diag”, “scott.diag”) |
| levels | 描画する領域の確率水準を(0, 1)で指定する数値ベクトル。kdeでは最高密度領域、mvnormでは被覆楕円になる | c(0.5, 0.8, 0.95) |
| points | 論理値。観測トークンを表示(2次元は点、1次元はラグ) | TRUE |
| overlap | 論理値。2つのカテゴリー密度の各点での最小値に網掛け(1次元はリボン、2次元は淡いラスタ)。網掛けの強さはパネル間で正規化される | TRUE |
| annotate | 論理値。描画した密度モデルにもとづくJensen-Shannon情報量と比率重なりを各パネルに表示 | TRUE |
| n_boot | 注釈の信頼区間に用いるブートストラップ再標本化数。既定の0は点推定のみ表示 | 0 |
| conf_level | ブートストラップ区間の信頼水準 | 0.95 |
| min_tokens | グループあたりの最小トークン数。これを下回るグループは警告のうえ除外(指標関数と同じ規約) | 20 |
| mc_n | density = “mvnorm”の注釈に使うモンテカルロ標本数。指標関数に渡される | 10000L |
| eval_seed | 注釈値を再現可能にするため指標関数に渡す任意の整数シード | NULL |
| grid_n | 密度評価のグリッド解像度(1軸あたりの点数)。既定は特徴量1個で512、2個で151 | NULL |
| point_alpha | 点(またはラグ)の透明度 | 0.55 |
| point_size | 2特徴量プロットでの点の大きさ | 1.6 |
| reverse_x | 論理値。軸を反転する(例:母音空間の慣例に沿ったF2×F1表示) | FALSE |
| reverse_y | 論理値。軸を反転する(例:母音空間の慣例に沿ったF2×F1表示) | FALSE |
| facet_scales | group_col指定時にggplot2::facet_wrap()へ渡すscales | c(“fixed”, “free”, “free_x”, “free_y”) |
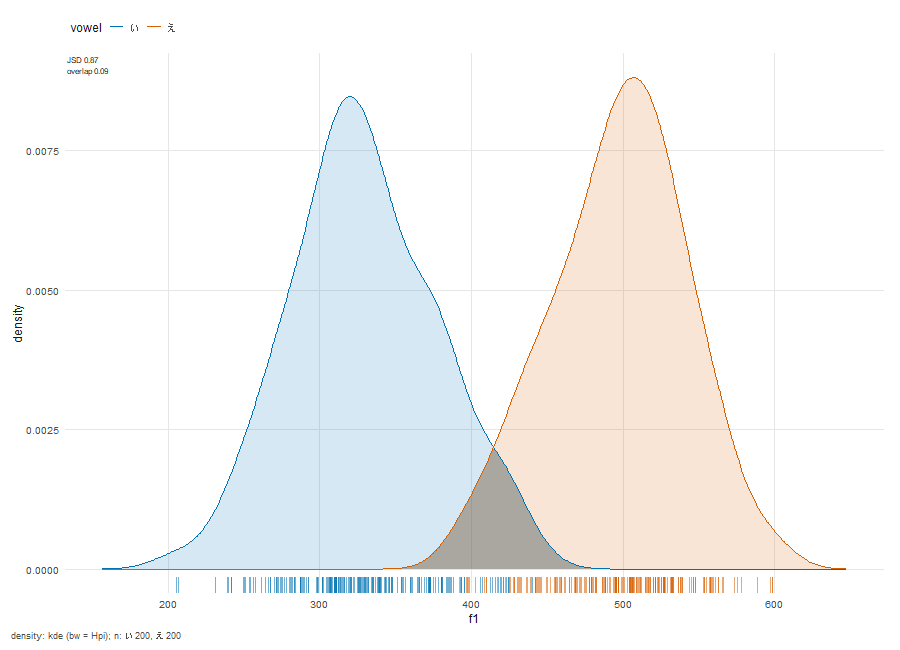
featuresに2つの特徴量を指定すると、密度領域を重ねた特徴量空間の図になります。1つだけ指定した場合は密度曲線になります。overlapで2つのカテゴリー密度が重なる範囲に網掛けし、annotateでJensen-Shannon情報量と比率重なりをパネルに注釈します。
# ggplot2が利用可能であれば対比図を描画
if (requireNamespace("ggplot2", quietly = TRUE)) {
  # 母音空間の慣例に合わせてF2を横軸に反転した対比図
  plot_contrast(boin, c("f2", "f1"), "vowel", reverse_x = TRUE, reverse_y = TRUE)
  # F1のみを使った1次元の対比図
  plot_contrast(boin, "f1", "vowel")
}
<おすすめのRに関する書籍です>

 www.amazon.co.jp
phontrastの算出結果を直接プロット:plotコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| x | phontrast()が返すphontrast_contrastオブジェクト | なし |
| … | plot_overlap_metrics()に渡す | なし |
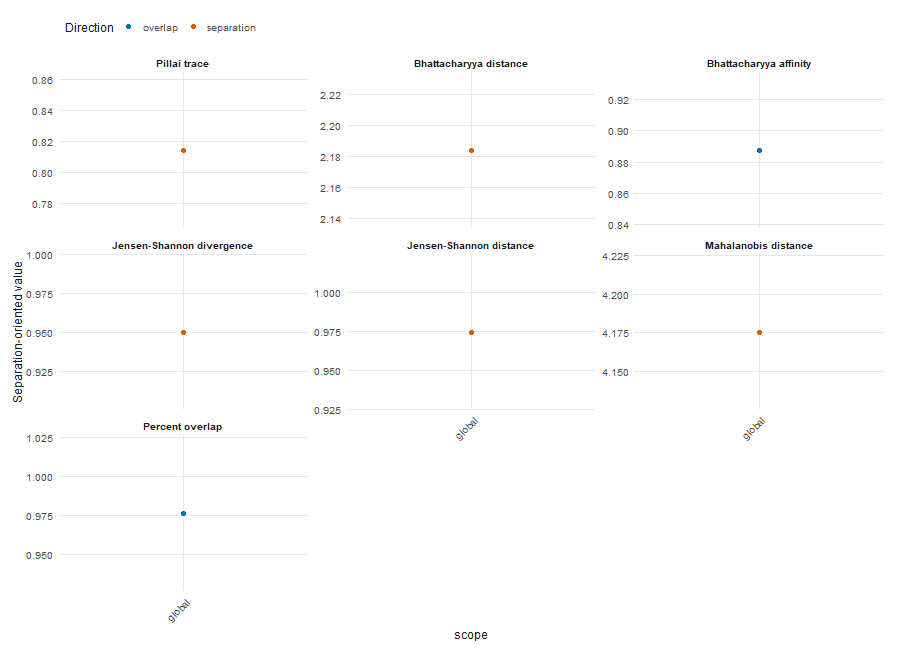
phontrastコマンドの戻り値(output = “long”)にはplotコマンドが用意されています。内部でplot_overlap_metricsコマンドを呼び出し、算出済みの指標をそのままプロットします。
# ggplot2が利用可能であればphontrastの縦持ち結果をそのままプロット
if (requireNamespace("ggplot2", quietly = TRUE)) {
  plot(phontrast(boin, c("f1", "f2"), "vowel", output = "long"))
}
高次元の音響特徴量をPCAで低次元に投影してプロット:plot_category_pcaコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| data | カテゴリを表す列と音響特徴量を含むデータフレーム | なし |
| features | PCAに用いる2個以上の数値特徴量列を表す文字列ベクトル | なし |
| category_col | カテゴリーを表す列名の文字列 | なし |
| group_col | パネル分割に使う任意のグループ化列 | NULL |
| components | プロットする主成分を指定する2つの正の整数 | c(1L, 2L) |
| center | stats::prcomp()に渡す | TRUE |
| scale. | stats::prcomp()に渡す | TRUE |
| points | 論理値。TRUEなら射影した観測値を表示 | TRUE |
| ellipses | 論理値。TRUEなら観測数が十分な場合に正規楕円を追加 | TRUE |
| point_alpha | 点の透明度 | 0.65 |
| point_size | 点の大きさ | 1.8 |
| equal_axes | 論理値。TRUEなら座標比を固定 | TRUE |
| facet_scales | group_col指定時にggplot2::facet_wrap()へ渡すscales | c(“fixed”, “free”, “free_x”, “free_y”) |
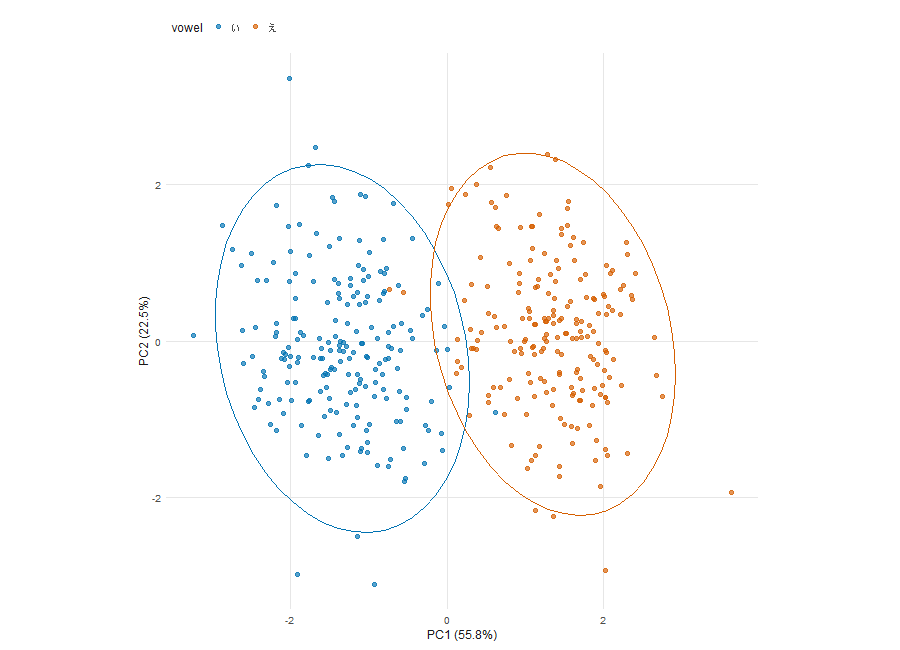
3個以上の音響特徴量を扱う場合に、主成分分析で2次元に投影してカテゴリーの分布を確認できます。componentsで表示する主成分を切り替えられます。
# ggplot2が利用可能であれば4つの音響特徴量をPCAで2次元に投影してプロット
if (requireNamespace("ggplot2", quietly = TRUE)) {
  plot_category_pca(boin, features = c("f1", "f2", "f3", "tilt"), category_col = "vowel")
}
音響空間における音韻カテゴリーのプロット:plot_category_spaceコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| data | カテゴリを表す列と音響特徴量を含むデータフレーム | なし |
| features | プロットする1〜2個の数値特徴量列 | なし |
| category_col | カテゴリーを表す列名の文字列 | なし |
| group_col | パネル分割に使う任意のグループ化列 | NULL |
| points | 論理値。TRUEなら観測トークンを表示 | TRUE |
| ellipses | 論理値。TRUEなら2特徴量プロットで観測数が十分な場合に正規楕円を追加 | TRUE |
| point_alpha | 点の透明度 | 0.65 |
| point_size | 点の大きさ | 1.8 |
| reverse_x | 論理値。TRUEならx軸を反転 | FALSE |
| reverse_y | 論理値。TRUEならy軸を反転 | FALSE |
| equal_axes | 論理値。TRUEなら2特徴量プロットで座標比を固定 | FALSE |
| facet_scales | group_col指定時にggplot2::facet_wrap()へ渡すscales | c(“fixed”, “free”, “free_x”, “free_y”) |
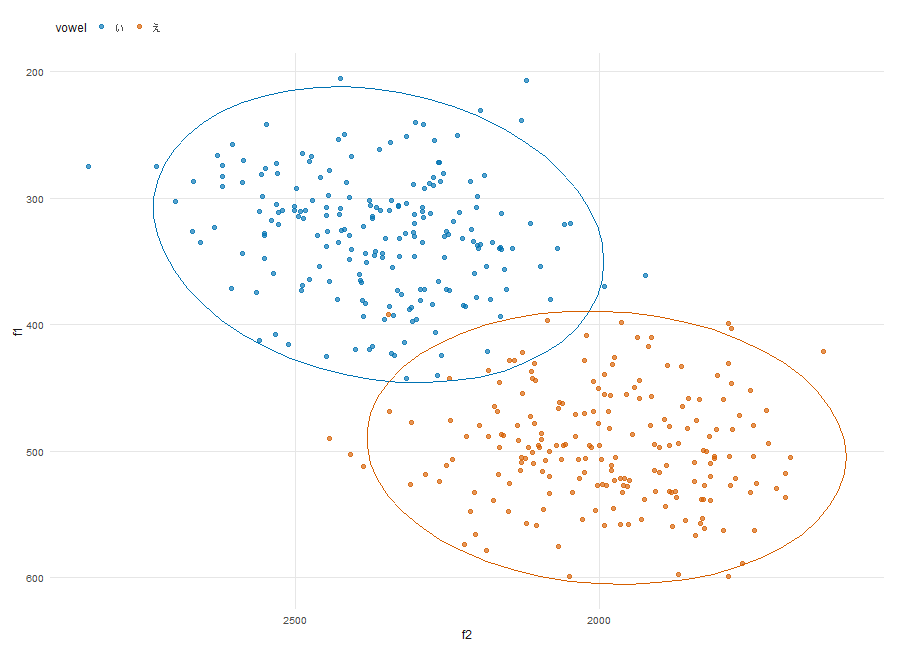
featuresに1〜2個の特徴量を指定し、観測トークンと正規楕円で音響空間上のカテゴリー分布をそのまま描画します。plot_contrastコマンドと異なり、密度領域や重なりの網掛けは表示しません。
# ggplot2が利用可能であればカテゴリ空間をプロット
if (requireNamespace("ggplot2", quietly = TRUE)) {
  # F1のみを使った1次元のカテゴリ空間
  plot_category_space(boin, features = "f1", category_col = "vowel")
  # 母音空間の慣例に合わせてF2とF1で2次元のカテゴリ空間
  plot_category_space(boin, features = c("f2", "f1"), category_col = "vowel",
                      reverse_x = TRUE, reverse_y = TRUE)
}
<おすすめのRに関する書籍です>
www.amazon.co.jp
地区間で分離・重なり指標を比較する棒グラフの作成:plot_overlap_metricsコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| metrics | phontrast()が返すデータフレーム | なし |
| value | プロットする尺度。separationはseparation_valueを、estimateは指標の生の推定値を描画 | c(“separation”, “estimate”) |
| metric | 対象とする指標の表示名を指定する任意の文字列ベクトル | NULL |
| group_col | x軸に使う任意の列。既定は”group”列があればそれ、なければ”scope” | NULL |
| show_ci | 論理値。TRUEならci_lower/ci_upper列がある場合に信頼区間を描画 | TRUE |
| facet | 論理値。TRUEなら指標ごとにパネル分割 | TRUE |
| sort | 論理値。TRUEなら描画値の平均で比較対象を並べ替え | TRUE |
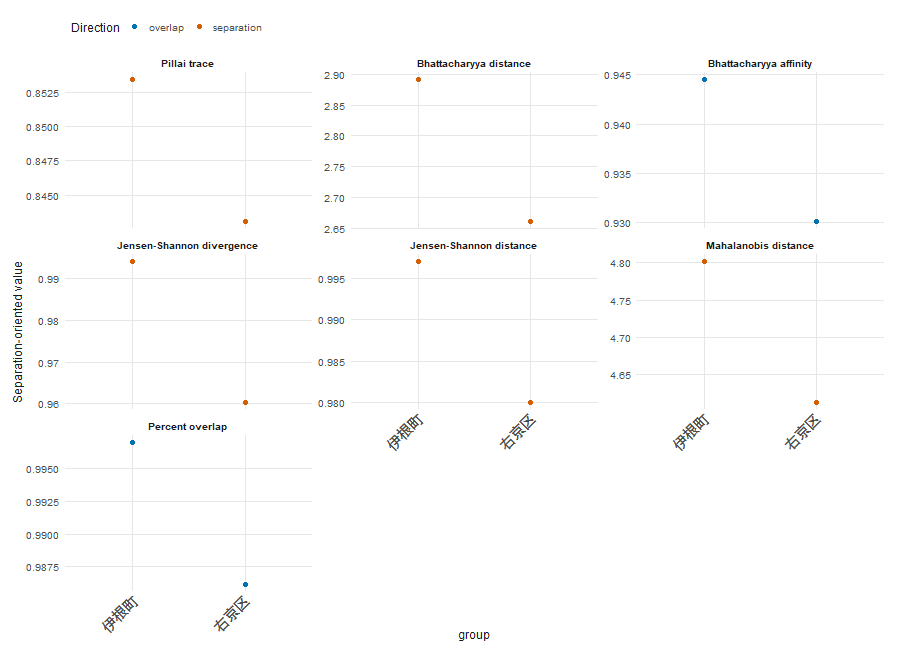
phontrastコマンドの縦持ち出力(複数のグループを含むもの)を渡すと、指標ごとにグループ間の値を比較する棒グラフを描画します。show_ciで信頼区間を、sortで比較対象の並べ替えを制御します。
# 地区ごとの分離・重なり指標を縦持ち形式で算出
chiku_shihyo <- phontrast(boin, features = c("f1", "f2"), category_col = "vowel",
                          group_col = "chiku", output = "long")
# ggplot2が利用可能であれば地区間を比較する棒グラフを描画
if (requireNamespace("ggplot2", quietly = TRUE)) {
  plot_overlap_metrics(chiku_shihyo)
}
phontrastパッケージの標準カラーパレットを取得:phontrast_paletteコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| n | 返す色数。既定はパレット全体 | NULL |
nを指定しない場合はパッケージ標準の8色を返します。色覚多様性に配慮した配色になっています。
# 標準の8色を取得
phontrast_palette()
      blue vermillion      green     orange     purple    skyblue     yellow
 "#0072B2"  "#D55E00"  "#009E73"  "#E69F00"  "#CC79A7"  "#56B4E9"  "#F0E442"
      grey
 "#999999"

# 先頭の2色のみを取得
phontrast_palette(2)
      blue vermillion
 "#0072B2"  "#D55E00"
phontrastの配色をggplot2に適用する色スケール:scale_colour_phontrastコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| … | ggplot2::discrete_scale()に渡す引数(name、labels、guideなど) | なし |
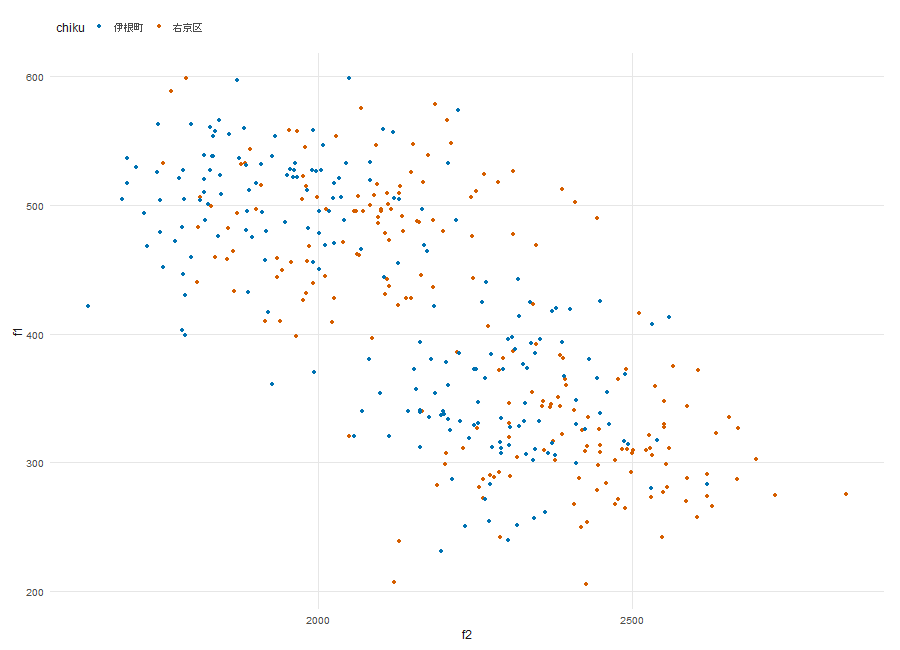
ggplot2のプロットにphontrastパッケージの配色とテーマをまとめて適用します。scale_colour_phontrastコマンドは離散スケール用で、scale_color_phontrastコマンドは同じ関数の別名です。
# ggplot2が利用可能であればphontrastの配色とテーマを適用
if (requireNamespace("ggplot2", quietly = TRUE)) {
  # 地区ごとに色分け
  ggplot2::ggplot(boin, ggplot2::aes(f2, f1, color = chiku)) +
    ggplot2::geom_point() +
    scale_colour_phontrast() +
    theme_phontrast()
}
<おすすめのRに関する書籍です>
 www.amazon.co.jp
この記事が誰かの役に立ちますように。