からだにいいもの
Rで解析:多様な成長曲線モデルを柔軟にあてはめ・比較する「flexFitR」パッケージの紹介
植物の生育や病害虫の増減など、時間とともに変化する現象を非線形モデルで表そうとすると、曲線の形によって数式やパラメータの初期値の与え方を使い分ける必要があります。しかし、曲線の種類ごとに最適化アルゴリズムを選び直したり、収束しない場合に初期値を手探りで調整したりするには手間がかかります。「flexFitR」パッケージは、汎用的な最適化アルゴリズムを用いて非線形モデルのあてはめを柔軟におこなえるパッケージです。直線・二次曲線・ロジスティック曲線・線形プラトーなど複数のコマンドが収録されており、複数のアルゴリズムを自動的に試してあてはめることが可能です。
グループごとの一括あてはめや、あてはめたモデル同士の分散分析による比較、影響診断情報の付加もおこなえます。また、データをあてはめる前に関数の形状をパラメータだけから確認したり、探索的にデータ間の相関を可視化したりすることも可能です。本パッケージの利用で、形の異なる複数の生育曲線を一貫した手順で扱えるのではないかと考えます。
パッケージバージョンは1.2.4。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>

 www.amazon.co.jp
パッケージのインストール
下記コマンドを実行してください。
# パッケージのインストール
install.packages("flexFitR")
# パッケージの読み込み
library("flexFitR")コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
モデルのあてはめ:modelerコマンド
modeler()は、本パッケージの中核となるコマンドです。データフレームの中から説明変数と目的変数の列を指定し、あらかじめ収録された成長曲線関数の中から1つを選んであてはめます。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | 解析対象のデータを格納したデータフレーム | なし |
| x | dataの列のうち、説明変数(x軸の値)となる列の名前 | なし |
| y | dataの列のうち、目的変数(応答変数)となる列の名前 | なし |
| grp | グルーピングに使う列名。複数指定可 | なし |
| keep | 出力に残しておく列名 | なし |
| fn | あてはめに使う関数名を指定する文字列。例:”fn_lin” | “fn_lin_plat” |
| parameters | パラメータの初期値。数値ベクトル・名前付きリスト・データフレームのいずれかで指定 | NULL |
| lower | パラメータの下限を指定する数値ベクトル | -Inf |
| upper | パラメータの上限を指定する数値ベクトル | Inf |
| fixed_params | 固定するパラメータをリストまたはデータフレームで指定 | NULL |
| method | 最適化に使うアルゴリズムを指定する文字ベクトル。list_methods()で確認可能 | c(“subplex”, “pracmanm”, “anms”) |
| subset | 解析対象とするgrpの水準を指定するベクトル | NULL |
| options | modeler.options()で指定する追加オプション(進捗表示・並列処理など) | modeler.options() |
| control | 最適化関数へ渡す制御パラメータのリスト。例:list(maxit = 500) | list() |
宇治市の茶畑を想定し、整枝後の一番茶の新芽の草丈(cm)を経過日数ごとに記録した架空データを作成します。生育の初期は緩やかに伸び、その後まっすぐ伸びて、摘採期が近づくとほぼ一定の高さで推移する形を想定し、線形プラトー関数(fn_lin_plat)であてはめます。
# 宇治市の茶畑における一番茶の新芽の生育データを作成
dt_ujicha <- data.frame(
  # 整枝後の経過日数
  day = c(0, 7, 14, 21, 28, 35, 42, 49, 56, 63, 70),
  # 新芽の草丈(cm)
  height = c(2.1, 4.8, 9.6, 16.5, 24.0, 29.8, 33.1, 34.6, 35.2, 35.4, 35.5)
)

# 線形プラトー関数でモデルをあてはめる
mo_uji <- modeler(dt_ujicha, x = day, y = height, fn = "fn_lin_plat",
                  parameters = c(t1 = 20, t2 = 45, k = 35))

# あてはめ結果を表示する
print(mo_uji)

Call:
height ~ fn_lin_plat(day, t1, t2, k)

Residuals (`Standardized`):
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
-1.2503 -0.2966  0.1147  0.1586  0.6268  1.7448

Optimization Results `head()`:
 uid   t1   t2    k  sse
   1 1.55 42.7 35.2 11.6

Metrics:
 Groups      Timing Convergence Iterations
      1 0.1604 secs        100%   334 (id)
t1(直線的な増加が始まる日)が1.55と、ほぼ整枝直後から伸び始め、t2(プラトーに達する日)は42.7日、プラトーの高さkは35.2cmと推定されました。
モデルオブジェクトに対する分散分析:anovaコマンド
パラメータ数の異なる2つのモデルをあてはめた場合、anova()で両者を比較し、パラメータを増やすことが統計的に有意な当てはまりの改善につながっているかを確認できます。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | 比較対象のうち、パラメータ数が少ない方(reduced)のmodelerクラスのオブジェクト | なし |
| full_model | 比較対象のうち、パラメータ数が多い方(full)のmodelerクラスのオブジェクト | NULL |
| … | 将来の拡張のための追加パラメータ | なし |
先ほどと同じ宇治茶のデータに、パラメータが少ない単純な直線モデル(fn_lin)もあてはめ、線形プラトーモデルと比較します。
# 単純な直線モデルをあてはめる(比較用の簡易モデル)
mo_lin <- modeler(dt_ujicha, x = day, y = height, fn = "fn_lin",
                  parameters = c(m = 0.7, b = 3))

# 直線モデルと線形プラトーモデルを分散分析で比較する
anova(mo_lin, mo_uji)
# A tibble: 1 × 9
    uid RSS_reduced RSS_full     n   df1   df2     F   `Pr(>F)` .
  <dbl>       <dbl>    <dbl> <int> <int> <int> <dbl>      <dbl> <fct>
1     1        188.     11.6    11     1     8  122. 0.00000406 ***
p値は0.00000406と非常に小さく、線形プラトーモデルへパラメータを増やしたことで、当てはまりが統計的に有意に改善していることが分かります。
影響診断情報の付加:augmentコマンド
augment()は、あてはめ結果に予測値・残差・影響診断量(てこ比やCookの距離など)を付加したデータフレームを返します。個々の観測値がモデルにどれだけ影響しているかを確認する際に使います。
| オプション | 意味 | 初期値 |
|---|---|---|
| x | modelerクラスのオブジェクト | なし |
| id | 特定のグループに絞り込むための任意の識別子 | NULL |
| metadata | 予測値にメタデータを含めるかどうかの指定 | TRUE |
| … | 将来の拡張のための追加パラメータ | なし |
線形プラトーモデルの当てはめ結果に、影響診断情報を付加します。
# 線形プラトーモデルの当てはめ結果に影響診断情報を付加する
augment(mo_uji)
# A tibble: 11 × 10
     uid fn_name         x     y .fitted  .resid  .hat   .cooksd .std.resid
   <dbl> <chr>       <dbl> <dbl>   <dbl>   <dbl> <dbl>     <dbl>      <dbl>
 1     1 fn_lin_plat     0   2.1    0     2.1    0     0             1.74
 2     1 fn_lin_plat     7   4.8    4.66  0.138  0.524 0.0101        0.115
 3     1 fn_lin_plat    14   9.6   10.7  -1.05   0.295 0.151        -0.873
 4     1 fn_lin_plat    21  16.5   16.6  -0.139  0.181 0.00120      -0.116
 5     1 fn_lin_plat    28  24     22.6   1.37   0.181 0.117         1.14
 6     1 fn_lin_plat    35  29.8   28.6   1.18   0.295 0.192         0.984
 7     1 fn_lin_plat    42  33.1   34.6  -1.50   0.524 1.20         -1.25
 8     1 fn_lin_plat    49  34.6   35.2  -0.575  0.25  0.0338       -0.478
 9     1 fn_lin_plat    56  35.2   35.2   0.0250 0.25  0.0000639     0.0208
10     1 fn_lin_plat    63  35.4   35.2   0.225  0.25  0.00518       0.187
11     1 fn_lin_plat    70  35.5   35.2   0.325  0.25  0.0108        0.270
# ℹ 1 more variable: .stud.resid <dbl>
0日目(整枝直後)の標準化残差が1.74と、他の観測点に比べてやや大きくなっています。整枝直後は生育速度が不安定になりやすい時期のため、モデルが表現しきれていない可能性があります。
<おすすめのRに関する書籍です>
 www.amazon.co.jp
超指数関数:fn_exp2_expコマンド
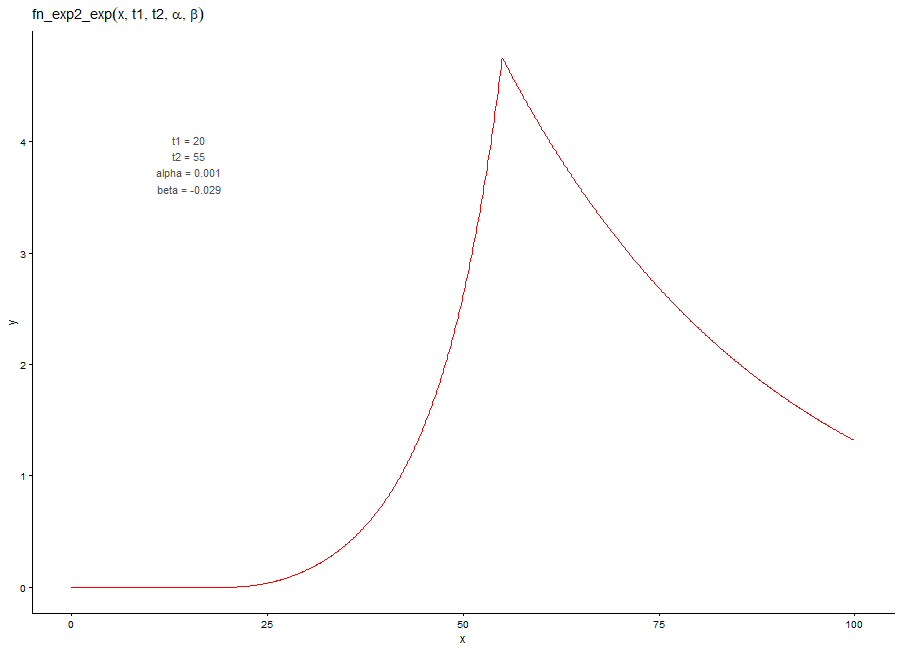
fn_exp2_expは、t1未満では値が0、t1からt2までは曲率を持つ指数フェーズ、t2以降は別の速度の指数フェーズに切り替わる、2段階の指数関数です。ある時点から急に増え始め、途中で増加から減少へ転じるような現象の表現に向いています。
| オプション | 意味 | 初期値 |
|---|---|---|
| t | 入力値(時間など)を格納する数値ベクトル | なし |
| t1 | 応答が始まる時点。この値未満では関数の値は0になる | なし |
| t2 | 2つの指数フェーズが切り替わる時点。t1より大きい値を指定する | なし |
| alpha | t1からt2までの第1フェーズにおける、曲率を決める指数の速度 | なし |
| beta | t2以降の第2フェーズにおける指数増加率 | なし |
舞鶴市の万願寺とうがらしの圃場で発生したアブラムシの個体数指数を想定します。定植から20日ほどはほとんど見られず、そこから急激に増加し、55日目あたりで天敵の増加や防除の効果によって増加から減少に転じるという設定です。plot_fn()を使うと、実際のデータをあてはめる前に、パラメータだけで曲線の形を確認できます。
# アブラムシの個体数指数の推移を超指数関数で描画する
plot_fn(
  fn = "fn_exp2_exp",
  params = c(t1 = 20, t2 = 55, alpha = 1 / 700, beta = -1 / 35),
  interval = c(0, 100),
  n_points = 1000
)
線形プラトー線形関数:fn_lin_pl_linコマンド
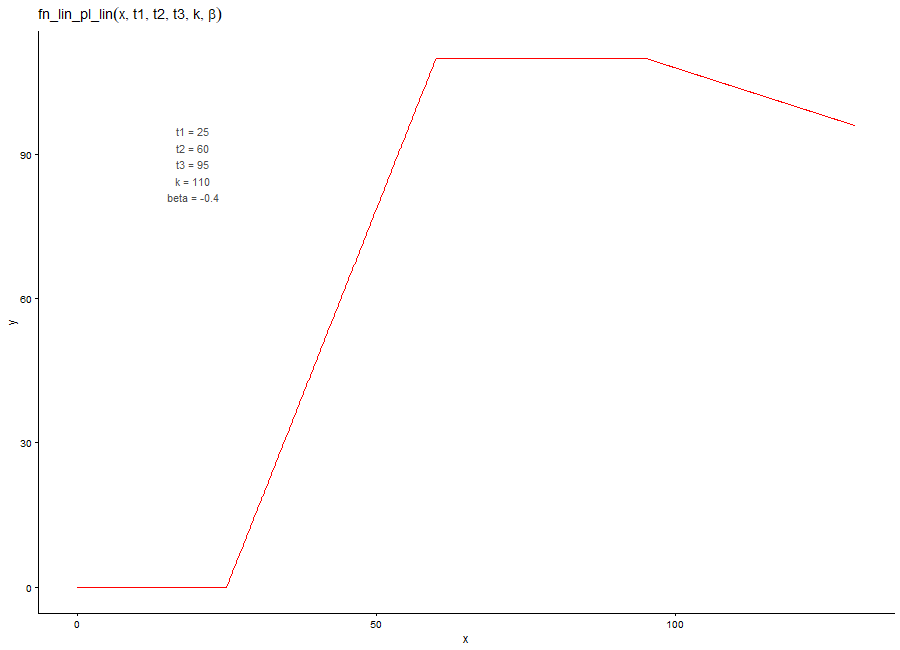
fn_lin_pl_linは、t1未満では0、t1からt2までは直線的に増加、t2からt3まではプラトー、t3以降は直線的に減少する、3段階の関数です。生育期・収穫最盛期・収穫終盤の衰えという3つの局面を持つ現象の表現に向いています。
| オプション | 意味 | 初期値 |
|---|---|---|
| t | 入力値(時間など)を格納する数値ベクトル | なし |
| t1 | 応答が始まる時点。この値未満では関数の値は0になる | なし |
| t2 | 直線的な増加フェーズが終わり、プラトーが始まる時点。t1より大きい値を指定する | なし |
| t3 | プラトーが終わり、直線的な減少が始まる時点。t2より大きい値を指定する | なし |
| k | プラトーの高さ。最初の直線フェーズがこの値まで増加し、t3までその値を保つ | なし |
| beta | t3以降の直線フェーズの傾き(通常は負の値)。減少の速さを決める | なし |
同じく舞鶴市の万願寺とうがらしを想定し、主茎の草丈の季節推移を表します。定植後25日でまっすぐ伸び始め、60日で伸びが止まってほぼ一定の高さを保ち、95日を過ぎると収穫終盤の摘心(芯止め)によって少しずつ低くなっていく、という設定です。
# 万願寺とうがらしの主茎草丈の推移を線形プラトー線形関数で描画する
plot_fn(
  fn = "fn_lin_pl_lin",
  params = c(t1 = 25, t2 = 60, t3 = 95, k = 110, beta = -0.4),
  interval = c(0, 130),
  n_points = 1000
)
ユーザー定義関数の描画:plot_fnコマンド
plot_fn()は、これまでの節でも使ってきたとおり、データをあてはめる前に、収録された成長曲線関数の形をパラメータだけから確認できるコマンドです。aucをTRUEにすると、指定した区間内の曲線下面積(AUC)も表示されます。
| オプション | 意味 | 初期値 |
|---|---|---|
| fn | 描画する関数名を指定する文字列 | “fn_lin_plat” |
| params | 関数に渡すパラメータを指定する名前付き数値ベクトル | c(t1 = 34.9, t2 = 61.8, k = 100) |
| interval | 関数を描画する区間を指定する長さ2の数値ベクトル | c(0, 100) |
| n_points | 描画に用いる点の数を指定する整数 | 1000 |
| auc | プロットにAUC(曲線下面積)を表示するかどうかの指定 | FALSE |
| x_auc_label | AUCラベルのx座標を指定する数値 | NULL |
| y_auc_label | AUCラベルのy座標を指定する数値 | NULL |
| auc_label_size | AUCラベルの文字サイズを指定する数値 | 4 |
| param_label_size | パラメータラベルの文字サイズを指定する数値 | 4 |
| base_size | プロットのテーマの基本サイズを指定する数値 | 12 |
| color | プロットの線と塗りつぶしの色を指定する文字列 | “red” |
| label_color | ラベルの色を指定する文字列 | “grey30” |
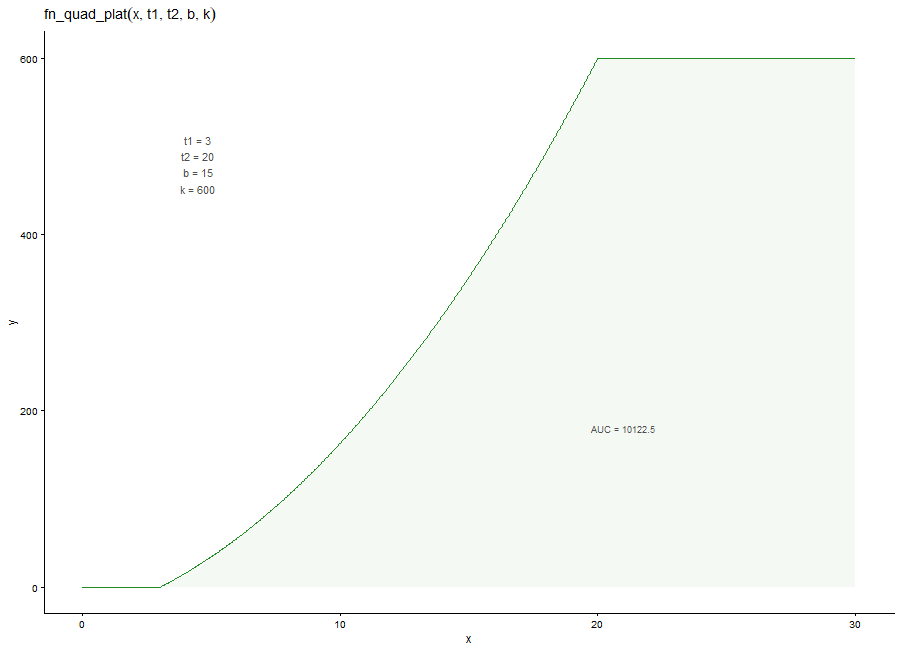
長岡京市の京たけのこを想定します。地上に姿を見せてから急激に伸び、成竹の高さに達するとほぼ一定になる生育を、二次プラトー関数(fn_quad_plat)で表します。aucをTRUEにして、0日目から20日目までの区間の曲線下面積もあわせて表示します。
# 京たけのこの生育曲線を二次プラトー関数で描画し、区間内の面積もあわせて表示する
plot_fn(
  fn = "fn_quad_plat",
  params = c(t1 = 3, t2 = 20, b = 15, k = 600),
  interval = c(0, 30),
  n_points = 1000,
  auc = TRUE,
  auc_label_size = 3,
  param_label_size = 4,
  color = "forestgreen",
  label_color = "grey30"
)
<おすすめのRに関する書籍です>
 www.amazon.co.jp
モデルオブジェクトの描画:plot.modelerコマンド
modeler()の結果をplot()に渡すと、生データと当てはめ曲線、係数の信頼区間など、typeの指定によってさまざまな図を描けます。grp引数で複数グループを一括であてはめた場合は、idで特定のグループに絞り込んで表示できます。
| オプション | 意味 | 初期値 |
|---|---|---|
| x | modelerクラスのオブジェクト(通常はmodeler()の実行結果) | なし |
| id | プロット対象を絞り込むための任意のグループID。過密なプロットを避けるのに便利 | NULL |
| type | 作成するプロットの種類を指定する1〜6の数値。1は生データと当てはめ曲線、2は信頼区間付きの係数、3はグループごとに色分けした当てはめ曲線、4は信頼区間付きの当てはめ曲線、5は信頼区間付きの1階微分、6は信頼区間付きの2階微分 | 1 |
| label_size | ラベルの大きさを指定する数値 | 4 |
| base_size | プロットの基本フォントサイズ(pt)を指定する数値 | 14 |
| linewidth | 線ジオムの太さを指定する数値 | 0.5 |
| color | type = 1のときの当てはめ線の色を指定する文字列 | “red” |
| color_points | type = 1のときの生データ点の色を指定する文字列 | “black” |
| parm | type = 2でプロットするパラメータを指定する文字ベクトル。NULLの場合はすべてのパラメータが対象 | NULL |
| n_points | x軸に沿った補間点の数を指定する数値 | 1000 |
| title | プロットに追加するタイトルの文字列 | NULL |
| add_points | type = 3・4で生データの観測値を追加するかどうかの指定 | FALSE |
| add_ci | type = 4・5・6で信頼区間を追加するかどうかの指定 | TRUE |
| color_ci | type = 4・5・6のときの信頼区間の色を指定する文字列 | “blue” |
| color_pi | type = 4のときの予測区間の色を指定する文字列 | “red” |
| add_ribbon_ci | type = 4・5・6で信頼区間のリボンを追加するかどうかの指定 | FALSE |
| add_ribbon_pi | type = 4で予測区間のリボンを追加するかどうかの指定 | FALSE |
| color_ribbon_ci | 信頼区間のリボンの色を指定する文字列 | “blue” |
| color_ribbon_pi | 予測区間のリボンの色を指定する文字列 | “red” |
| … | 将来の拡張のための追加のグラフィックパラメータ | なし |
舞鶴市内の4圃場(A〜D)で栽培する万願寺とうがらしを想定し、定植後の経過日数ごとの主茎草丈(cm)を記録した架空データを作成します。圃場ごとにロジスティック関数であてはめます。
# 舞鶴市内4圃場における万願寺とうがらしの草丈データを作成
dt_manganji <- data.frame(
  # 圃場名
  Plot = rep(c("A", "B", "C", "D"), each = 7),
  # 定植後の経過日数
  day = rep(c(0, 15, 30, 45, 60, 75, 90), 4),
  # 主茎の草丈(cm)
  height = c(0.2, 1.8, 17.9, 64.2, 91.0, 94.3, 95.0,
             0.2, 1.5, 7.2, 35.9, 72.4, 85.6, 87.5,
             0.2, 2.9, 25.6, 80.9, 96.2, 98.3, 97.7,
             0.2, 0.7, 5.9, 24.2, 59.6, 77.0, 81.4)
)

# 圃場ごとにロジスティック関数でモデルをあてはめる
mo_manganji <- modeler(dt_manganji, x = day, y = height, grp = Plot,
                       fn = "fn_logistic",
                       parameters = c(a = 0.15, t0 = 45, k = 95))

# あてはめ結果を表示する
print(mo_manganji)

Call:
height ~ fn_logistic(day, a, t0, k)

Residuals (`Standardized`):
    Min.  1st Qu.   Median     Mean  3rd Qu.     Max.
-1.32709 -0.66696 -0.04595  0.01398  0.67249  1.38450

Optimization Results `head()`:
 uid     a   t0    k   sse
   A 0.148 40.0 95.1 0.756
   B 0.130 48.0 87.9 0.646
   C 0.172 36.0 98.0 0.451
   D 0.121 52.1 82.1 0.620

Metrics:
 Groups      Timing Convergence Iterations
      4 0.3088 secs        100% 748.5 (id)
4圃場のうちCが最も生育が早く(t0 = 36.0)、Dが最も遅い(t0 = 52.1)と推定されました。圃場AとCに絞って、生データと当てはめ曲線を描きます。
# 圃場AとCに絞って、生データと当てはめ曲線を描画する(type = 1)
plot(mo_manganji, id = c("A", "C"), type = 1)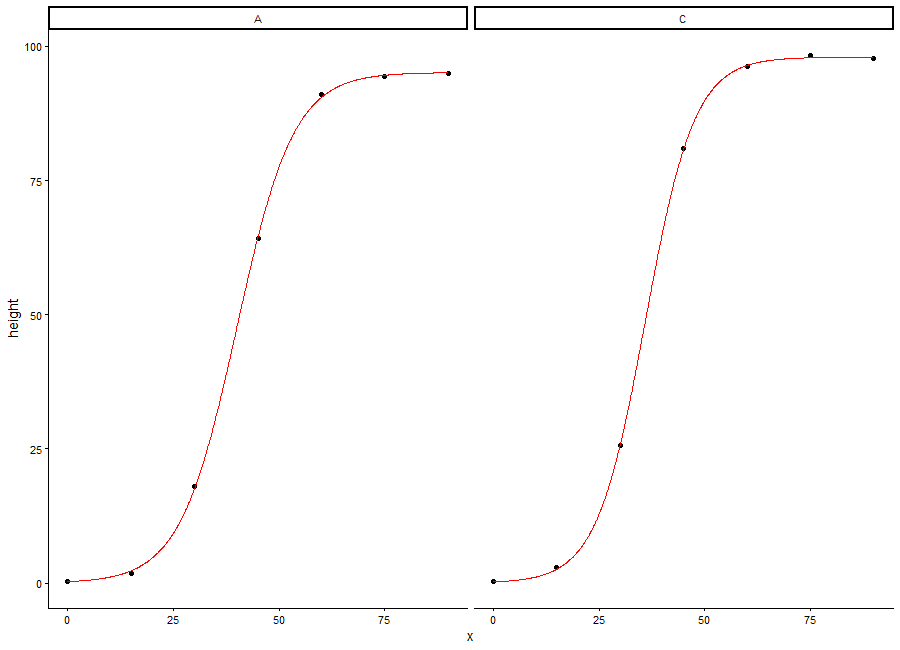
次に、全圃場の係数と信頼区間を1つの図にまとめて描画します。
# 全圃場の係数と信頼区間を描画する(type = 2)
plot(mo_manganji, type = 2, label_size = 5)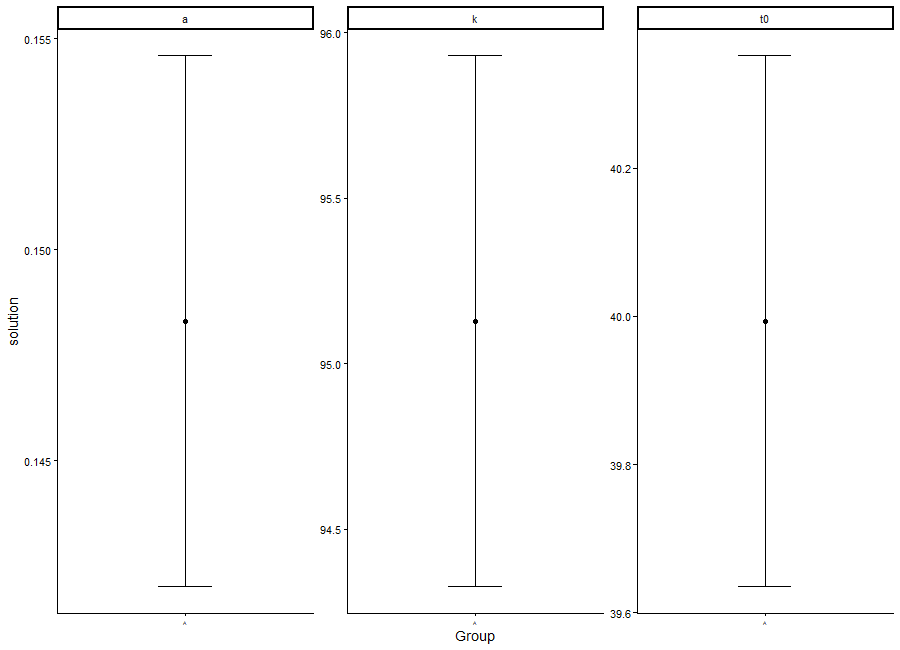
探索オブジェクトの描画:plot.explorerコマンド
explorer()は、モデルをあてはめる前にデータの傾向をつかむためのコマンドです。x・y・idを指定してexplorerクラスのオブジェクトを作成し、plot()に渡すことで、複数の変数間の相関や時間変化を確認できます。
| オプション | 意味 | 初期値 |
|---|---|---|
| x | explorer()の実行結果であるexplorerクラスを継承したオブジェクト | なし |
| type | 作成するプロットの種類を指定する文字列または数値。”var_by_x”または1は変数間のxごとの相関、”x_by_var”または2は変数ごとのxの値同士の相関、”evolution”または3は変数(y)の時間変化、”xy”または4は散布図(x, y) | “var_by_x” |
| label_size | プロット内のラベルの大きさを指定する数値。type 1・2でのみ有効 | 4 |
| signif | TRUEの場合、相関プロットのラベルにp値を追加する。type 1・2でのみ有効 | FALSE |
| method | 相関係数の計算方法を指定する文字列。”pearson”・”spearman”・”kendall”から選択。type 1・2でのみ有効 | “pearson” |
| filter_var | プロットから除外する変数を指定する文字ベクトル | NULL |
| id | evolutionタイプのプロットで絞り込む任意の識別子。type 3でのみ有効 | NULL |
| n_row | facet_wrap()で使う行数を指定する整数。type 1・2でのみ有効 | NULL |
| n_col | facet_wrap()で使う列数を指定する整数。type 1・2でのみ有効 | NULL |
| base_size | プロットの基本フォントサイズを指定する数値 | 13 |
| return_gg | TRUEの場合、プロットを表示する代わりにggplotオブジェクトを返す | FALSE |
| add_avg | TRUEの場合、evolutionプロットにグループ平均の推移を追加する | FALSE |
| … | 将来の改良のための追加のグラフィックパラメータ | なし |
先ほどの万願寺とうがらしのデータに、圃場ごとの葉数を追加し、草丈と葉数の関係を探索します。
# 圃場ごとの葉数データを追加する
dt_manganji$leaf <- c(0.1, 0.8, 5.5, 21.1, 29.2, 30.7, 30.5,
                      0.1, 0.3, 2.6, 11.5, 23.6, 27.3, 28.4,
                      0.1, 1.0, 8.1, 26.4, 30.9, 31.9, 31.3,
                      0.1, 0.1, 2.1, 7.5, 19.4, 24.6, 26.4)

# 探索オブジェクトを作成する
ex_manganji <- explorer(dt_manganji, x = day, y = c(height, leaf), id = Plot)

# 経過日数ごとの草丈と葉数の相関を描画し、相関表を受け取る
soukan <- plot(ex_manganji, type = "var_by_x", label_size = 4, signif = TRUE)

# 相関表を表示する
soukan
# A tibble: 6 × 7
      x col    row    corr  p.value     n signi
  <dbl> <fct>  <fct> <dbl>    <dbl> <dbl> <fct>
1    15 height leaf   0.93 0.0725       4 ns
2    30 height leaf   1    0.00127      4 **
3    45 height leaf   1    0.000102     4 ***
4    60 height leaf   1    0.000168     4 ***
5    75 height leaf   1    0.00118      4 **
6    90 height leaf   1    0.000643     4 ***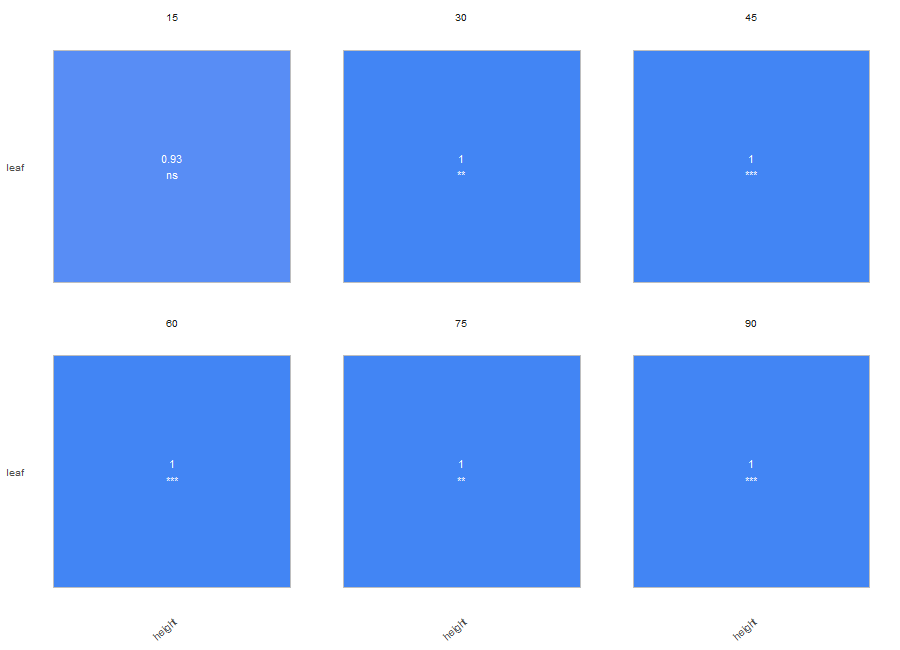
定植直後の15日目だけは相関が有意でない(signi = ns)一方、30日目以降は草丈と葉数がいずれも強く相関しています。最後に、4圃場の草丈の推移を、圃場平均の線を添えて描画します。
# 4圃場の草丈の推移を平均線つきで描画する
plot(ex_manganji, type = "evolution", add_avg = TRUE)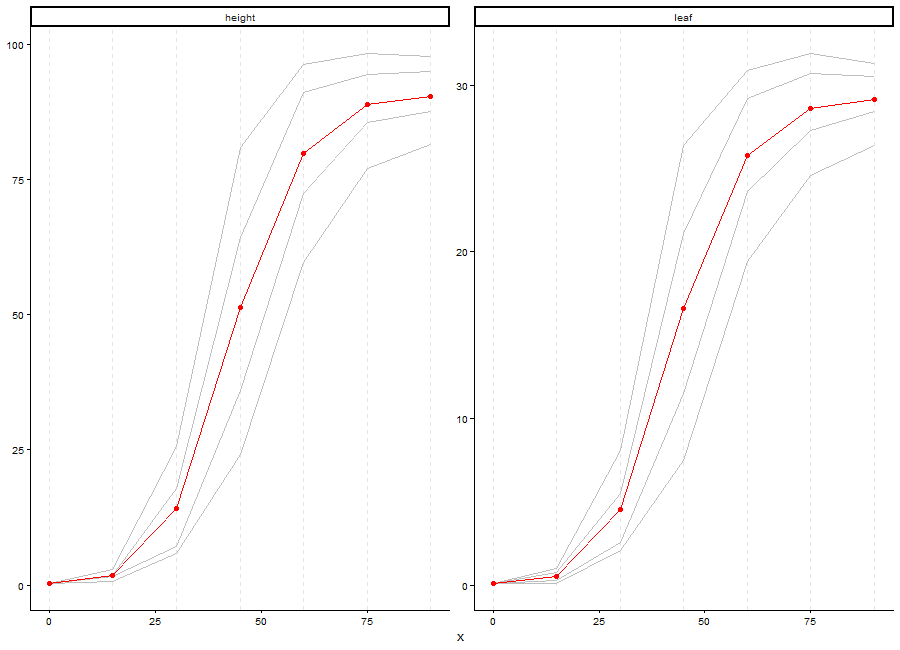
<おすすめのRに関する書籍です>
 www.amazon.co.jp
この記事が誰かの役に立ちますように。