からだにいいもの
Rで解析:バイオインフォマティクスの図をブラウザで高速プロット!!「plotomics」
膨大な遺伝子発現量や多数の変異、細胞の座標といった生命科学のデータを、ブラウザ上で動くインタラクティブな図として描けるパッケージです。「plotomics」パッケージは、発現量のヒートマップやクラスター化したヒートマップ、ドットプロット、ツリーマップ、ネットワーク図など、バイオインフォマティクスでよく使う十数種類のコマンドを提供します。
プロット処理をブラウザ側のGPUとcanvasに任せるため、行数が多いデータでも表示が重くなりにくく、結果はRStudioのViewerやWebブラウザ、R MarkdownやShinyアプリにそのまま埋め込めます。大規模な解析結果を、動作を保ったまま整理して見せることができるのではないかと考えます。
パッケージバージョンは0.1.0。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>
パッケージのインストール
下記コマンドを実行してください。
# パッケージのインストール
install.packages("plotomics")

# パッケージの読み込み
library("plotomics")コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
plotomicsの各コマンドは、htmlwidgetsの仕組みでHTMLとJavaScriptの図を返します。戻り値はRStudioのViewerやWebブラウザ、R Markdown、Quartoにそのまま表示でき、描画そのものはブラウザのGPUとcanvasが担います。そのため数千点を超えるデータでも拡大や移動が滑らかに動きます。Shinyアプリに載せるときは、各コマンドに対応する出力用コマンド(末尾がOutput)と描画用コマンド(先頭がrender)の対を使います。
以降のコマンド例では、京都府内の産地と京野菜、観光地の周遊を題材にした擬似データを、コマンドごとに用意して使います。
数値行列をヒートマップにする:bioheatmapコマンド
数値行列をそのままヒートマップにするコマンドです。行名と列名が軸ラベルになり、colormapで連続配色の”viridis”と発散配色の”rdbu”を選べます。z_scoreをTRUEにすると行ごとに標準化してから色を割り当てるので、値の絶対量がそろっていない行どうしでも相対的な高低を比べやすくなります。vminとvmaxで色の範囲を固定できます。
| オプション | 意味 | 初期値 |
|---|---|---|
| mat | 行と列からなる数値行列。行名・列名があれば軸の目盛りラベルに使う | なし |
| colormap | 配色。”viridis”(連続)または”rdbu”(発散) | c(“viridis”, “rdbu”) |
| z_score | TRUEで各行をZスコア化してから色付けする(行を中心化したヒートマップ) | FALSE |
| vmin | 色の範囲の下限のクランプ値。NULLではデータから自動で決め、”rdbu”では0を中心に対称にする | NULL |
| vmax | 色の範囲の上限のクランプ値。NULLではデータから自動で決め、”rdbu”では0を中心に対称にする | NULL |
| show_colorbar | カラーバーの凡例を描画するかどうか | TRUE |
| theme | 配色やフォントなどをまとめた名前付きリスト。ブラウザ側で既定に重ねて適用する。NULLで既定のテーマ | NULL |
| width | ウィジェットの幅。有効なCSSのサイズ指定 | NULL |
| height | ウィジェットの高さ。有効なCSSのサイズ指定 | NULL |
| element_id | DOM要素のidを明示的に指定する | NULL |
# 乱数の種を固定
set.seed(1234)

# 京野菜7品種の名前
varieties <- c(
  "九条ねぎ", "賀茂なす", "万願寺とうがらし", "聖護院かぶ",
  "京たけのこ", "山科なす", "伏見とうがらし"
)

# 出荷先とする府内9地区の名前
regions <- c(
  "左京区", "右京区", "伏見区", "山科区", "宇治市",
  "亀岡市", "長岡京市", "南丹市", "和束町"
)

# 品種ごとの月平均出荷量(kg)
base <- c(820, 540, 470, 610, 390, 500, 450)

# 品種を行、地区を列とした月間出荷量の行列を作成
ship <- round(outer(base, runif(length(regions), 0.6, 1.4)) +
  matrix(rnorm(length(varieties) * length(regions), 0, 50),
    nrow = length(varieties)
  ))

# 行名に品種名を設定
rownames(ship) <- varieties

# 列名に地区名を設定
colnames(ship) <- regions

# 行ごとにZスコア化し、品種内での地区差を色で示す
bioheatmap(ship, z_score = TRUE)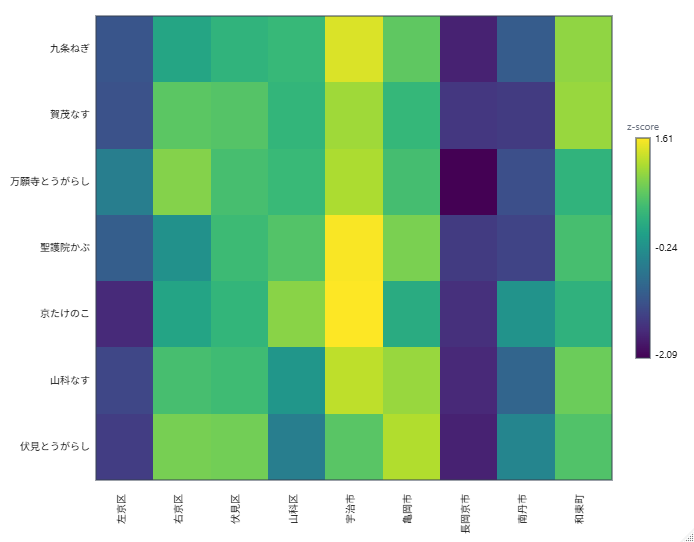
値を各地区の平均からの差に変換し、発散配色で多い地区と少ない地区を塗り分けます。
# 各地区の値を、その地区の平均からの差に変換
dif <- sweep(ship, 2, colMeans(ship))

# 発散配色で平均より多い地区と少ない地区を塗り分け、色の範囲を上下200に固定
bioheatmap(dif, colormap = "rdbu", vmin = -200, vmax = 200)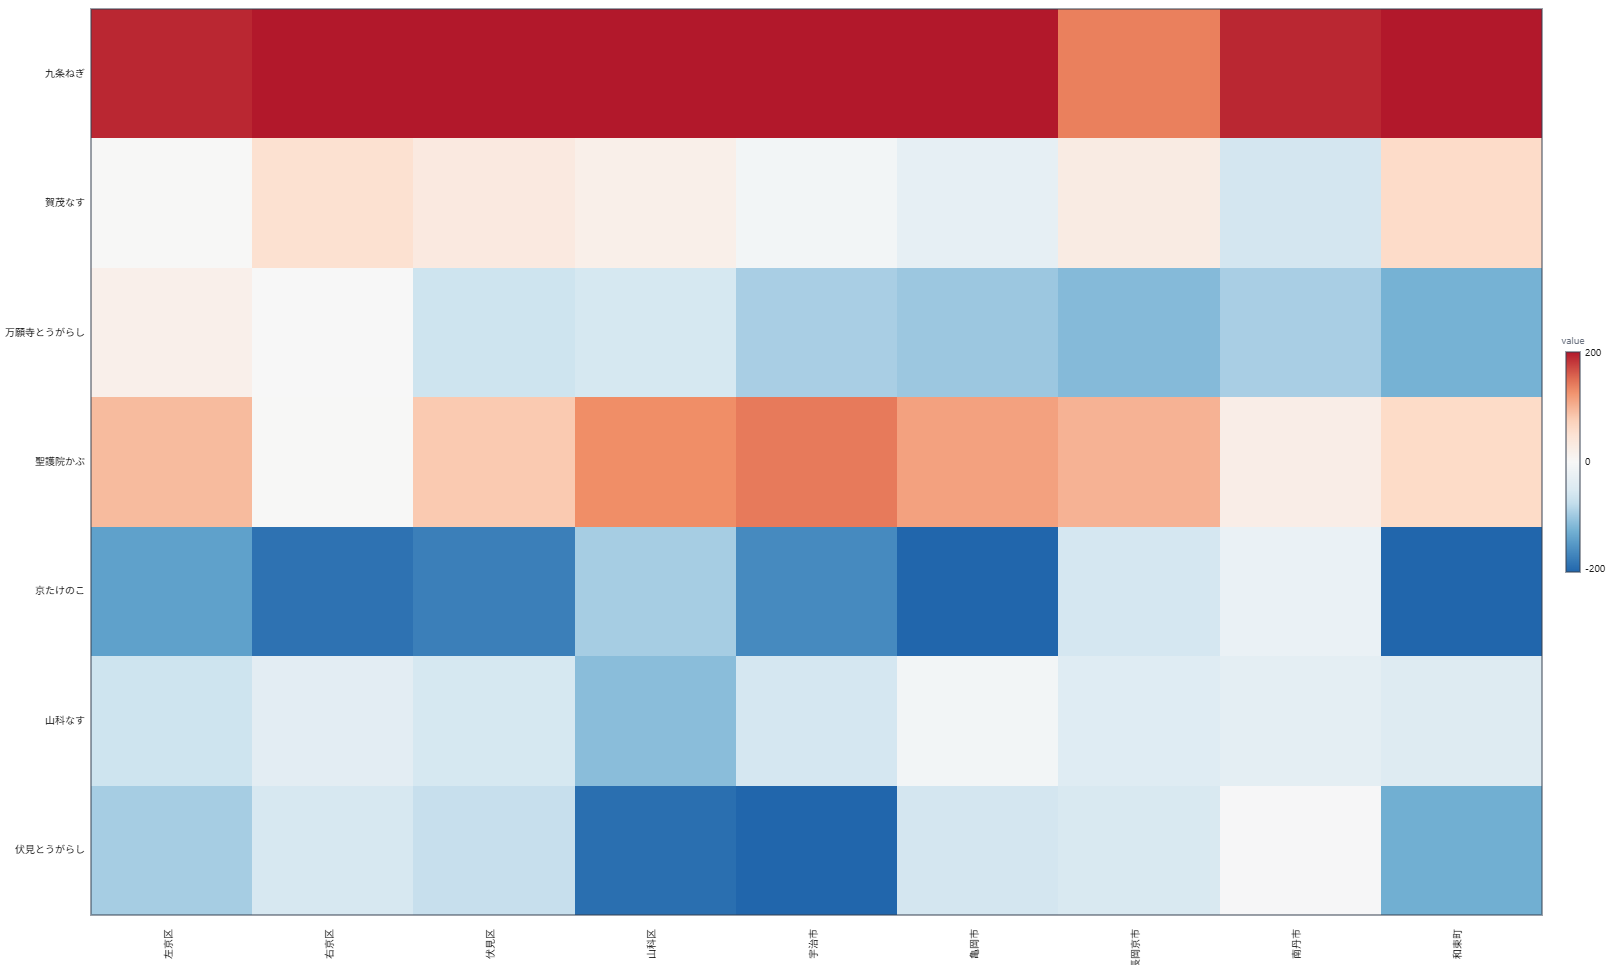
行と列をクラスター化して描く:clustermapコマンド
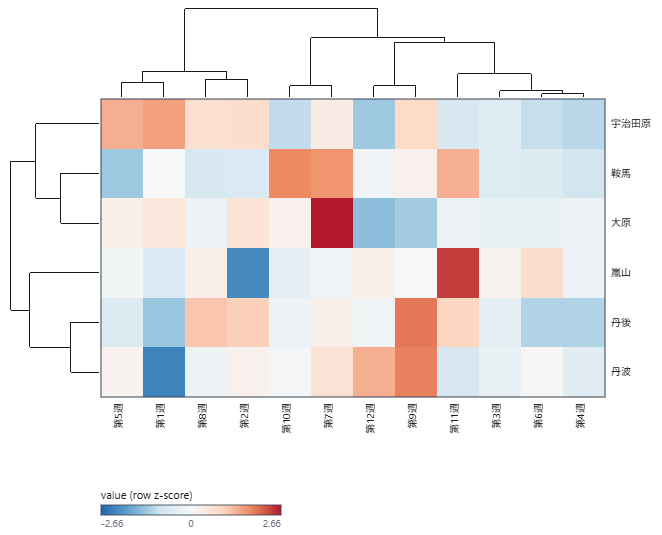
行と列を距離に基づいて並べ替え、樹状図を添えて描画します。metricで距離尺度(”euclidean”か”correlation”)、linkageで結合方法(”average”、”complete”、”ward”)を指定します。cluster_rowsやcluster_colsをFALSEにすると、その軸は元の並び順のまま固定できます。legend_titleでカラーバーの見出しを変えられます。
| オプション | 意味 | 初期値 |
|---|---|---|
| mat | 数値行列。行名・列名があればラベルに使う。値は行優先でブラウザへ渡される | なし |
| metric | クラスタリングの距離尺度。”euclidean”または”correlation”(1からピアソン相関を引いた値) | c(“euclidean”, “correlation”) |
| linkage | 凝集の方法。”average”、”complete”、”ward” | c(“average”, “complete”, “ward”) |
| colormap | 配色。”viridis”(連続)または”rdbu”(発散) | c(“viridis”, “rdbu”) |
| z_score | 色付け前に各行を平均0・標準偏差1へ標準化する | FALSE |
| cluster_rows | 行をクラスター化して並べ替える。row_linkageを与えた軸では無視される | TRUE |
| cluster_cols | 列をクラスター化して並べ替える。col_linkageを与えた軸では無視される | TRUE |
| show_row_dendrogram | 行の樹状図を描画する | TRUE |
| show_col_dendrogram | 列の樹状図を描画する | TRUE |
| show_labels | 行・列の目盛りラベルを描画する。セルが小さすぎて読めないときは自動で隠す | TRUE |
| legend_title | カラーバーの凡例の見出し | “value” |
| row_linkage | 事前に計算した葉の順序または樹状図。与えるとその軸のクラスタリングを省く。0始まりの整数ベクトル、またはorderとmergesを持つリスト | NULL |
| col_linkage | 事前に計算した葉の順序または樹状図。与えるとその軸のクラスタリングを省く。0始まりの整数ベクトル、またはorderとmergesを持つリスト | NULL |
| theme | 配色やフォントなどをまとめた名前付きリスト。ブラウザ側で既定に重ねて適用する。NULLで既定のテーマ | NULL |
| width | ウィジェットの幅。有効なCSSのサイズ指定 | NULL |
| height | ウィジェットの高さ。有効なCSSのサイズ指定 | NULL |
| element_id | DOM要素のidを明示的に指定する | NULL |
# 乱数の種を固定
set.seed(1234)

# 一番茶の収量を観測する6地点の名前
sites <- c("嵐山", "大原", "宇治田原", "丹波", "丹後", "鞍馬")

# 観測する週数を設定
weeks <- 12

# 南部3地点は平均52で推移する収量(kg/10a)を作成
south <- matrix(rnorm(3 * weeks, mean = 52, sd = 4), nrow = 3)

# 北部3地点は平均38で推移する収量を作成
north <- matrix(rnorm(3 * weeks, mean = 38, sd = 4), nrow = 3)

# 南部・北部を縦に結合して地点を行、週を列とする行列にする
tea <- rbind(south, north)

# 行名に地点名を設定
rownames(tea) <- sites

# 列名に週のラベルを設定
colnames(tea) <- paste0("第", seq_len(weeks), "週")

# 相関距離とward法で地点と週をクラスター化し、行を標準化して描画
clustermap(tea,
  metric = "correlation", linkage = "ward",
  colormap = "rdbu", z_score = TRUE
)
週の並びは時系列のまま固定し、地点だけをクラスター化します。
# 列(週)は時系列の並びのまま固定し、行(地点)だけをクラスター化する
# 凡例の見出しを日本語にする
clustermap(tea,
  cluster_cols = FALSE, show_col_dendrogram = FALSE,
  legend_title = "収量(標準化)"
)

長形式データを点の大小と色で示す:dotplotコマンド
1行1点の長形式データフレームから、点の大きさと色でふたつの量を同時に示すドットプロットを描きます。gene列とcluster列が縦横の見出しになり、pct列が点の大きさ、value列が点の色に対応します。genesとclustersで行と列の並び順を、value_labelとsize_labelで凡例の見出しを指定できます。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | 1行1点の長形式データフレーム。品目を表すgene列とグループを表すcluster列、点の大きさになるpct列(発現割合、0〜100)、点の色になるvalue列(発現量)を持つ | なし |
| genes | 行の並び順を固定する文字列ベクトル。gene列が因子ならその水準から取る。既定は出現順 | NULL |
| clusters | 列の並び順を同様に固定する文字列ベクトル | NULL |
| value_label | 色の凡例の見出し | “mean expression” |
| size_label | 大きさの凡例の見出し | “% expressing” |
| colormap | 色チャンネルの連続配色。”viridis”、”rdbu”、”ltc”(土色みのティールからサンド、ラストへ向かう連続配色)、”ltcdiv”(その発散版で中点がクリーム色) | c(“viridis”, “rdbu”, “ltc”, “ltcdiv”) |
| max_radius | 100%の点の半径(ピクセル) | 9 |
| value_domain | 色スケールを固定する長さ2の数値ベクトル。NULLでデータの範囲を使う。2つのドットプロットを並べて比べるときに指定する | NULL |
| show_grid | 格子線の表示を切り替える | TRUE |
| show_legend | 凡例の表示を切り替える | TRUE |
| theme | 配色やフォントなどをまとめた名前付きリスト。NULLで既定のテーマ | NULL |
| width | ウィジェットの幅。有効なCSSのサイズ指定 | NULL |
| height | ウィジェットの高さ。有効なCSSのサイズ指定 | NULL |
| element_id | DOM要素のidを明示的に指定する | NULL |
# 乱数の種を固定
set.seed(1234)

# 行に並べる京野菜5品目
items <- c("九条ねぎ", "賀茂なす", "万願寺とうがらし", "聖護院かぶ", "京たけのこ")

# 列に並べる直売所のある5地区
areas <- c("左京区", "右京区", "伏見区", "亀岡市", "南丹市")

# 品目と地区の総当たり表を長形式で作成
sales <- expand.grid(gene = items, cluster = areas, stringsAsFactors = FALSE)

# その品目を扱う店の割合(%)を点の大きさ用に付与
sales$pct <- round(runif(nrow(sales), 10, 95))

# 1kgあたりの平均販売価格(円)を点の色用に付与
sales$value <- round(rnorm(nrow(sales), 1000, 250))

# 割合を点の大きさ、価格を点の色として描画
dotplot(sales)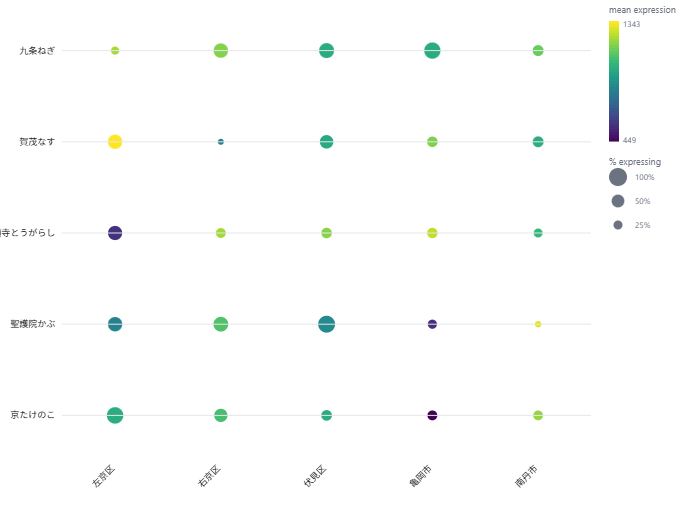
行と列の並びを指定し、凡例の見出しと配色を変更します。
# 行と列の並びを品目・地区の指定順に固定する
# 凡例の見出しを日本語にし、配色をltcに変更する
dotplot(sales,
  genes = items, clusters = areas,
  value_label = "平均価格(円)", size_label = "取扱店率(%)",
  colormap = "ltc"
)
階層を入れ子の面積で表す:treemapコマンド
idとparentでつないだエッジリストから、階層構造を入れ子の長方形で表します。value列が葉の重みになり、内部ノードの大きさは自動で合計されます。color_byを”parent”にすると最上位の地域ごとに、”value”にすると重みの大小で色が付きます。tileでタイルの分割方法、padding_innerで区切りの余白を調整します。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | 木構造をエッジリストで表したデータフレーム。必須列はid(一意のノードid)とparent(親のid。根の親はNAまたは空文字)。数値のvalue列が葉の重みを与え、内部ノードは自動で合計される。任意のlabel列が表示名を与える | なし |
| tile | タイル分割のアルゴリズム。”squarify”(黄金比に近い長方形)または”binary”(均衡した2分割) | c(“squarify”, “binary”) |
| padding_inner | 隣り合うタイルの間隔(ピクセル) | 1 |
| color_by | 葉の色分けの基準。”parent”(最上位の祖先で分類)または”value”(連続・発散配色) | c(“parent”, “value”) |
| colormap | color_byが”value”のときの配色。”viridis”または”rdbu” | c(“viridis”, “rdbu”) |
| label_min_size | ラベルを描画するタイルの一辺の最小値(ピクセル) | 32 |
| theme | 配色やフォントなどをまとめた名前付きリスト。ブラウザ側で既定に重ねて適用する。NULLで既定のテーマ | NULL |
| width | ウィジェットの幅。有効なCSSのサイズ指定 | NULL |
| height | ウィジェットの高さ。有効なCSSのサイズ指定 | NULL |
| element_id | DOM要素のidを明示的に指定する | NULL |
# 産地の木構造をエッジリストで作成する
# idは一意の名前、parentは親のid、valueは葉の作付面積(ha)
prod <- data.frame(
  id = c(
    "root", "丹波", "山城", "丹後",
    "丹波黒大豆", "丹波栗", "賀茂なす", "九条ねぎ", "宇治茶", "丹後こしひかり"
  ),
  parent = c(
    "", "root", "root", "root",
    "丹波", "丹波", "山城", "山城", "山城", "丹後"
  ),
  value = c(
    0, 0, 0, 0,
    120, 45, 30, 210, 180, 260
  ),
  label = c(
    "京都府全体", "丹波", "山城", "丹後",
    "丹波黒大豆", "丹波栗", "賀茂なす", "九条ねぎ", "宇治茶", "丹後こしひかり"
  ),
  stringsAsFactors = FALSE
)

# 最上位の地域ごとに色を分けてツリーマップを描画
treemap(prod)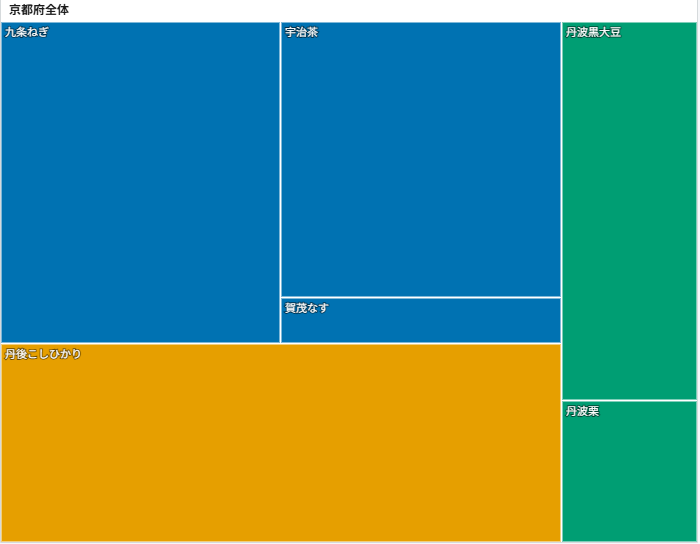
葉の作付面積の大小で色を付け、タイルの余白を広げます。
# 葉の作付面積の大小で色を付け、タイルの余白を3ピクセルに広げる
treemap(prod, color_by = "value", colormap = "viridis", padding_inner = 3)
<おすすめのRに関する書籍です>

 www.amazon.co.jp
ノードとエッジで関係図を描く:networkコマンド
ノードの表とエッジの表から、node-link形式の関係図を描きます。nodesにはid列が必須で、group列を付けるとカテゴリごとに色分けされます。edgesはsource列とtarget列でノードを結び、weight列があれば線の太さに反映されます。layoutを”forceatlas2″にすると座標が無くてもブラウザ側で配置を計算し、iterationsでその反復回数を指定します。
| オプション | 意味 | 初期値 |
|---|---|---|
| nodes | ノードのデータフレーム。文字列に変換されるid列が必須。任意でx・y(座標)、size(半径、ピクセル)、group(カテゴリ。配色に対応づく)、label(表示名。既定はid) | なし |
| edges | エッジのデータフレーム。ノードidを入れたsource列とtarget列、任意で線の太さになる数値のweight列、エッジごとの色を与えるcolor列を持つ | なし |
| layout | “forceatlas2″(座標が無いときレイアウトを計算する)または”precomputed”(nodesのx・yを必ず使う) | c(“forceatlas2”, “precomputed”) |
| iterations | ForceAtlas2の反復回数。内部で上限が設けられる | 200 |
| default_node_color | groupが無いノードに使う既定の色 | “#7c8598” |
| default_edge_color | エッジの色 | “#d6dae1” |
| label_threshold | ラベルを描画するノードの最小サイズ(ピクセル) | 8 |
| default_node_size | sizeが無いときに使うノードの半径(ピクセル) | 4 |
| directed | 有向グラフとして矢印付きで描画する。TRUEではA→BとB→Aを別のエッジとして残し、FALSEでは逆向きの対を1本にまとめる | FALSE |
| palette | ノードのグループに使う既定の配色を上書きする16進数カラーのベクトル | NULL |
| theme | 配色やフォントなどをまとめた名前付きリスト。ブラウザ側で既定に重ねて適用する。NULLで既定のテーマ | NULL |
| width | ウィジェットの幅。有効なCSSのサイズ指定 | NULL |
| height | ウィジェットの高さ。有効なCSSのサイズ指定 | NULL |
| element_id | DOM要素のidを明示的に指定する | NULL |
# 周遊の拠点になる観光エリアをノードとして定義する
# groupはエリアの方面、sizeはノードの大きさ
nodes <- data.frame(
  id = c(
    "京都駅", "嵐山", "金閣寺", "銀閣寺", "清水寺",
    "伏見稲荷", "宇治", "天橋立", "鞍馬"
  ),
  group = c(
    "中心", "洛西", "洛北", "洛東", "洛東",
    "洛南", "洛南", "府北部", "洛北"
  ),
  size = c(14, 10, 9, 8, 10, 9, 7, 6, 5),
  stringsAsFactors = FALSE
)

# 拠点間の移動をエッジとして定義する
# weightは1日あたりの推定周遊者数
edges <- data.frame(
  source = c(
    "京都駅", "京都駅", "京都駅", "京都駅", "京都駅",
    "嵐山", "金閣寺", "清水寺", "伏見稲荷", "宇治"
  ),
  target = c(
    "嵐山", "清水寺", "伏見稲荷", "金閣寺", "天橋立",
    "金閣寺", "銀閣寺", "銀閣寺", "宇治", "天橋立"
  ),
  weight = c(120, 150, 110, 90, 25, 40, 55, 60, 45, 15),
  stringsAsFactors = FALSE
)

# エリアの方面ごとに色分けし、ForceAtlas2レイアウトで配置して描画
network(nodes, edges, layout = "forceatlas2")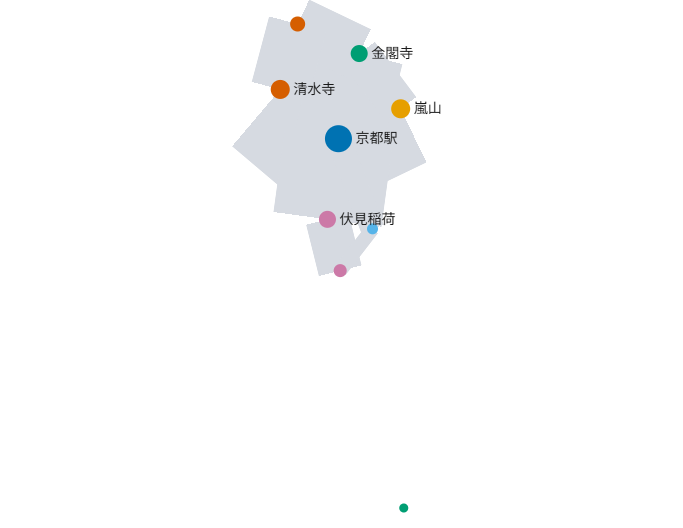
反復回数を増やして配置を落ち着かせ、小さいノードにもラベルを出します。
# 反復回数を増やして配置を安定させ、ラベルを出すノードサイズの下限を下げる
network(nodes, edges, iterations = 400, label_threshold = 4)
<おすすめのRに関する書籍です>
 www.amazon.co.jp
この記事が誰かの役に立ちますように。