からだにいいもの
Rで解析:文章からタグクラウドをプロットする「tagcloud」パッケージ
「tagcloud」パッケージは、文章や検索キーワードに出てくる語を、数の多いものほど大きな文字にして1枚の図にまとめることができます。渡すものは、語のベクトルと、語ごとの数値のベクトルの2つで、集計した表をそのまま使えます。文字の大きさと色、語を詰める形は数値から決まります。アンケートの自由記述や問い合わせの記録を、読み込む前に全体の傾向として眺めたい人におすすめです。
「tagcloud」パッケージのバージョンは0.7.0。Windows 11 x64 (build 26200)のR version 4.6.1でコマンドを確認しています。
<おすすめのRに関する書籍です>

 www.amazon.co.jp
パッケージのインストール
# パッケージのインストール
install.packages("tagcloud")

# パッケージの読み込み
library("tagcloud")コマンド例
タグクラウドは、ワードクラウドとも呼ばれるます。語を数値の順に並べるのではなく、数値を文字の大きさに置き換えて1枚に詰めて配置します。順位を正確に読む図ではなく、どの語が目立つかを一目で掴むための図です。
入力に使うのは、語のベクトルと、語ごとの数値のベクトルです。日本語の文章をそのまま渡しても語には分かれないため、語に分ける処理は別に用意します。ここでは、語がスペースで区切られた問い合わせの記録を使い、tableコマンドで数えたものを入力にしています。
# 和束町の茶畑案内所に寄せられた問い合わせの語を用意
Toiawase <- c(
  "茶畑 見学 和束町 駐車場", "茶摘み 体験 5月 予約", "宇治茶 直売所 和束町",
  "茶畑 展望台 石寺 行き方", "抹茶 体験 子ども 和束町", "新茶 茶摘み 体験 予約",
  "茶畑 見学 バス 行き方", "和束町 茶畑 撮影 展望台", "煎茶 直売所 宇治茶",
  "茶摘み 体験 雨天 中止", "茶畑 見学 団体 予約", "和束町 抹茶 和菓子",
  "茶香服 体験 和束町", "茶畑 展望台 駐車場 石寺", "宇治茶 玉露 直売所",
  "茶摘み 体験 5月 子ども", "和束町 茶畑 見学 予約", "ほうじ茶 直売所 和束町",
  "茶畑 撮影 新茶 5月", "手もみ 体験 煎茶 予約", "和束町 バス 行き方 駐車場",
  "茶畑 見学 英語 案内", "宇治茶 抹茶 和菓子 直売所", "茶摘み 体験 団体 予約",
  "石寺 茶畑 展望台 撮影", "和束町 宿泊 茶摘み 体験", "茶畑 見学 5月 新茶",
  "直売所 煎茶 玉露 値段", "茶摘み 体験 予約 変更", "和束町 茶畑 紅葉 撮影"
)

# 問い合わせを語ごとに分ける
Tango <- unlist(strsplit(Toiawase, " "))

# 語の出た数を数え、多い順に並べる
TangoHyo <- sort(table(Tango), decreasing = TRUE)

# 上位20語をデータフレームにまとめる
Testdata <- data.frame(Tango = names(TangoHyo), Kensu = as.numeric(TangoHyo))[1:20, ]

# 数の多い語を確認
head(Testdata, 10)
    Tango Kensu
1    茶畑    12
2  和束町    11
3    体験    10
4  茶摘み     7
5    予約     7
6    見学     6
7  直売所     6
8     5月     4
9  宇治茶     4
10   撮影     4
語の出現数を文字の大きさにする:tagcloudコマンド
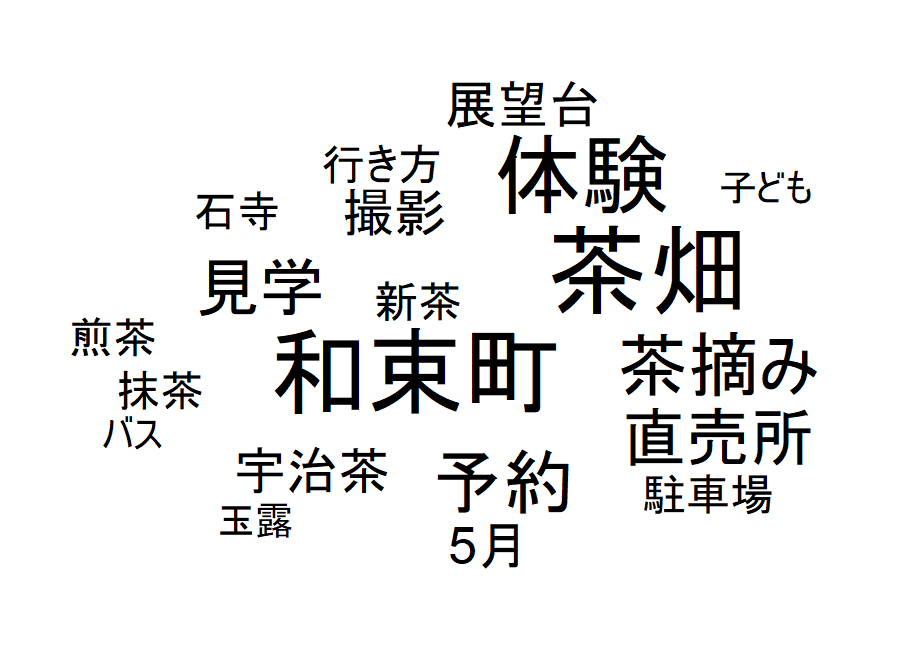
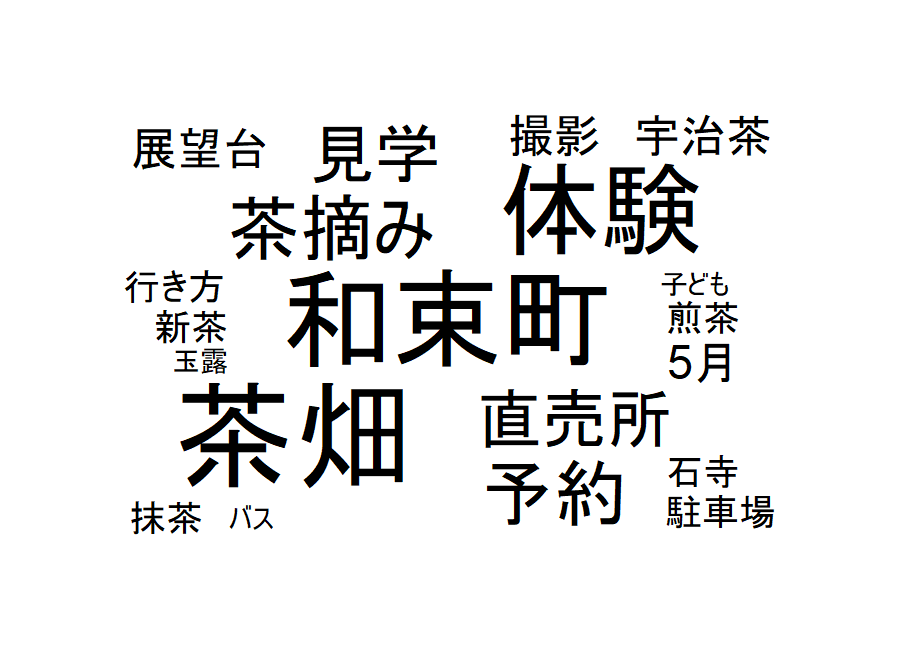
tagsオプションに語を、weightsオプションに語ごとの数値を渡します。文字の大きさは、weightsオプションの値をfloorオプションからceilingオプションまでの範囲に割り当てて決まります。語を詰める形はalgorithmオプションで選べ、”oval”で楕円、”fill”で四角い領域を埋める配置になります。書体を変えるときはfamilyオプションを使います。
# 語を出現数の大きさでプロット
tagcloud(Testdata$Tango, weights = Testdata$Kensu)
語を出た数の大きさでプロット
# 語を隙間に詰めて配置し、文字の大きさの幅を広げる
tagcloud(Testdata$Tango,
  weights = Testdata$Kensu,
  algorithm = "fill", floor = 1, ceiling = 5
)
語を隙間に詰めて配置し、文字の大きさの幅を広げる
| オプション | 意味 | 初期値 |
|---|---|---|
| tags | 図に載せる語の文字ベクトル | なし |
| weights | 語ごとの文字の大きさの比になる数値ベクトル | 1 |
| algorithm | 語を詰める方法。”oval”、”fill”、”random”、”snake”、”list”、”clist”から選ぶ | “oval” |
| scale | “auto”で文字の大きさを領域に合わせて計算する。数値を渡すと計算結果をその値で調整する | “auto” |
| scale.multiplier | 計算した文字の大きさに掛ける値。余白が多いときは大きく、図からはみ出すときは小さくする | 1 |
| order | 語を置く順序。”size”、”keep”、”random”、”height”、”width”から選ぶ | “size” |
| sel | 載せる語を選ぶ整数または論理値のベクトル。colとweightsも合わせて絞り込まれる | NULL |
| wmin | weightsのうちこの値より小さい値をこの値に揃える | NULL |
| wmax | weightsのうちこの値より大きい値をこの値に揃える | NULL |
| floor | 文字の大きさの下限 | 1 |
| ceiling | 文字の大きさの上限 | 3 |
| family | 使う書体。語ごとに指定するベクトルも渡せる。”random”を渡すと書体を無作為に割り当てる(extrafontパッケージが要る) | NULL |
| col | 語の色。語ごとに指定するベクトルも渡せる | NULL |
| fvert | 反時計回りに90度回して置く語の割合 | 0 |
| weightiscex | TRUEでweightsを文字の大きさそのものとして扱う。scale = 1と合わせると値がそのまま大きさになる | FALSE |
| plot | FALSEでプロットしない | TRUE |
| add | TRUEで新しい図を作らず、今の図に重ねる | FALSE |
数の大小を色で示す:smoothPaletteコマンド
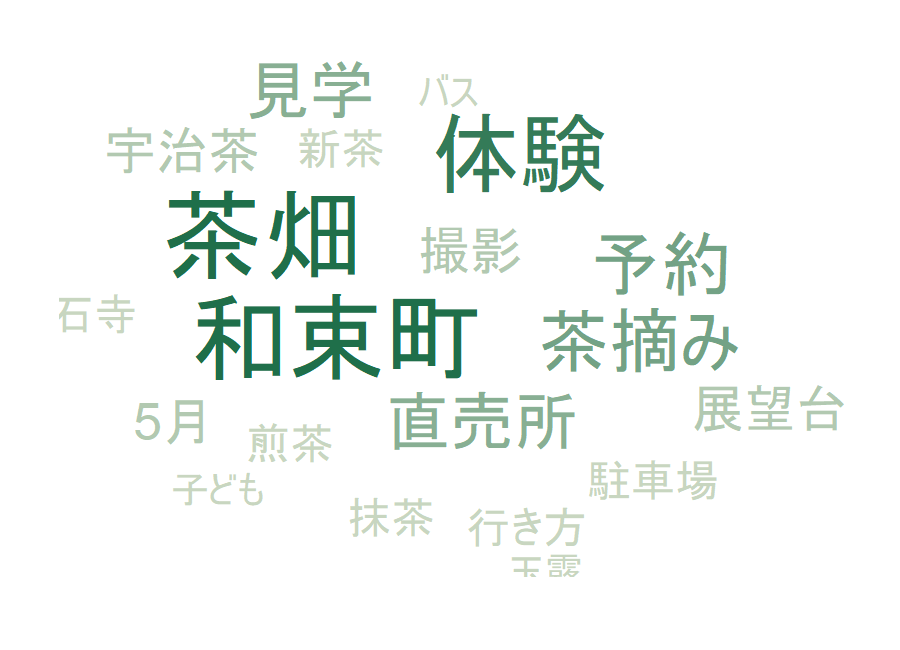
数値のベクトルを、色の並びに割り当てて返すコマンドです。返ってきた色をtagcloudコマンドのcolオプションに渡すと、文字の大きさと色の両方で数の大小を示せます。色の並びは、palfuncオプションにcolorRampPaletteコマンドの返り値を渡すか、palオプションにRColorBrewerのパレット名を渡して決めます。
# 数の少ない語を薄い緑、多い語を濃い緑にする
Iro <- smoothPalette(Testdata$Kensu, palfunc = colorRampPalette(c("#c8d6c0", "#1f6f4a")))

# 先頭5語に割り当てた色を確認
head(Iro, 5)
[1] "#1F6F4A" "#1F6F4A" "#347B58" "#73A285" "#73A285"

# 色を付けてプロット
tagcloud(Testdata$Tango, weights = Testdata$Kensu, col = Iro)
色を付けてプロット
| オプション | 意味 | 初期値 |
|---|---|---|
| x | 色に置き換える数値ベクトル | なし |
| pal | xを割り当てる色の並びを指定する文字ベクトル。初期値では白から黒までの並びになる。1つの文字列を渡すとRColorBrewerのパレット名として扱う | NULL |
| max | xのうちこの値より大きい値をこの値に揃える | NULL |
| min | xのうちこの値より小さい値をこの値に揃える | NULL |
| n | 色の段階の数 | 9 |
| palfunc | colorRampPaletteコマンドが返す色の割り当て | NULL |
| na.color | NAに割り当てる色 | “white” |
<おすすめのRに関する書籍です>
 www.amazon.co.jp
長い語を折り返す:strmultlineコマンド
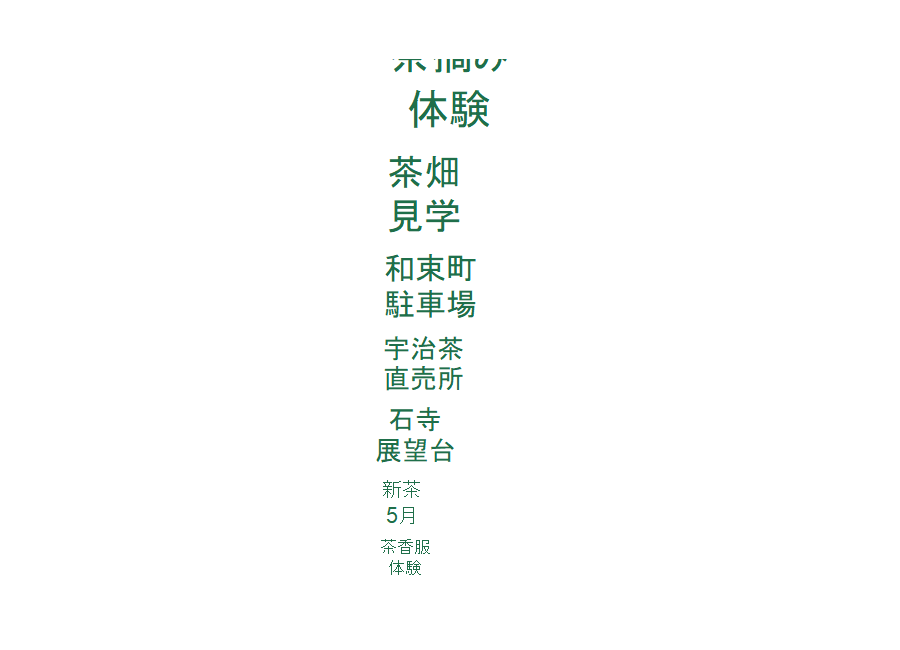
スペースで区切られた語のまとまりを、縦横の比が揃うように改行で折り返して返すコマンドです。「茶摘み 体験」のような2語のまとまりを図に載せるとき、横に長い文字列のままでは小さくなってしまうので、折り返してから渡します。ratioオプションで、折り返した後の高さと幅の比を指定します。
# 問い合わせに多かった語の組み合わせを用意
Kumi <- c(
  "茶摘み 体験", "茶畑 見学", "和束町 駐車場", "宇治茶 直売所",
  "石寺 展望台", "新茶 5月", "茶香服 体験", "抹茶 和菓子"
)

# 組み合わせごとの件数を用意
KumiKensu <- c(9, 7, 5, 4, 4, 3, 2, 2)

# 組み合わせを2行に折り返す
strmultline(Kumi)
[1] "茶摘み\n体験"   "茶畑\n見学"     "和束町\n駐車場" "宇治茶\n直売所"
[5] "石寺\n展望台"   "新茶\n5月"      "茶香服\n体験"   "抹茶\n和菓子"

# 折り返した語を縦に並べ、図に収まる大きさでプロット
tagcloud(strmultline(Kumi),
  weights = KumiKensu, algorithm = "list",
  col = "#1f6f4a", scale.multiplier = 0.75
)
折り返した語を縦に並べ、図に収まる大きさでプロット
| オプション | 意味 | 初期値 |
|---|---|---|
| strings | 折り返す、複数の語からなる文字ベクトル | なし |
| ratio | 折り返した後の高さと幅の比 | 0.2 |
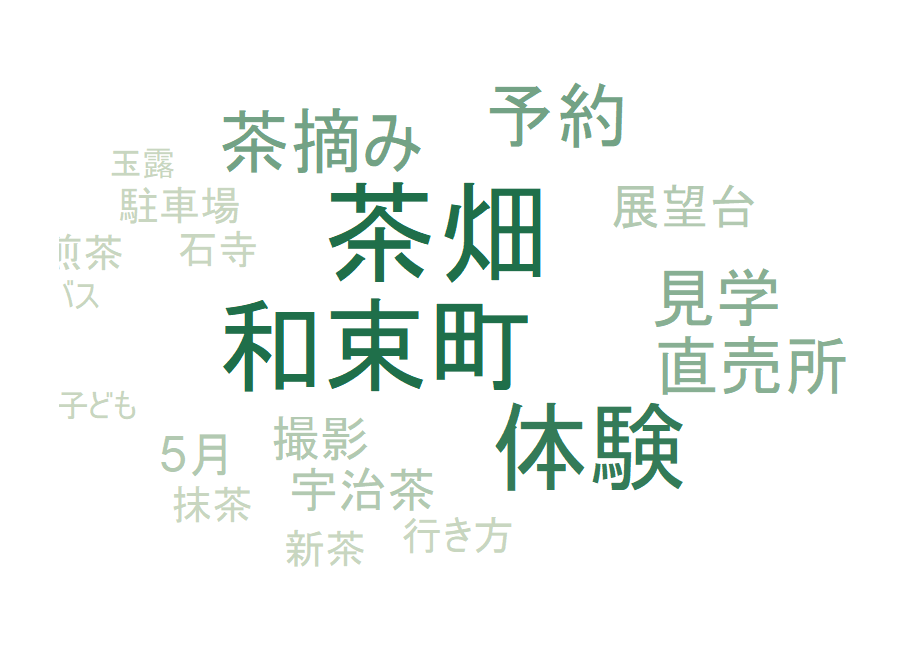
文字の大きさを先に求める:calc.cexコマンド
数値のベクトルを、文字の大きさ(cex)のベクトルに置き換えて返すコマンドです。tagcloudコマンドが内部で行う計算と同じものを、先に手元で取り出せます。求めた値を確認したり、一部の語だけ大きさを揃えたりしたいときに使います。返ってきた値をweightsオプションに渡し、weightiscexオプションをTRUEにすると、求めた大きさの比のままプロットされます。scaleオプションに1を渡すと計算した値がそのまま文字の大きさになりますが、図の領域が広いときは小さく収まります。
# 件数を1倍から4倍の文字の大きさに置き換える
Cex <- calc.cex(Testdata$Kensu, floor = 1, ceiling = 4)

# 先頭5語の文字の大きさを確認
head(Cex, 5)
[1] 3.50 3.25 3.00 2.25 2.25

# 求めた大きさの比のままプロット
tagcloud(Testdata$Tango, weights = Cex, weightiscex = TRUE, col = Iro)
求めた大きさの比のままプロット
| オプション | 意味 | 初期値 |
|---|---|---|
| x | 文字の大きさに置き換える数値ベクトル | なし |
| floor | 求める文字の大きさの下限 | 1 |
| ceiling | 求める文字の大きさの上限 | 3 |
| wmin | xのうちこの値より小さい値をこの値に揃える | NULL |
| wmax | xのうちこの値より大きい値をこの値に揃える | NULL |

同じ配置で色を変える:plotコマンド
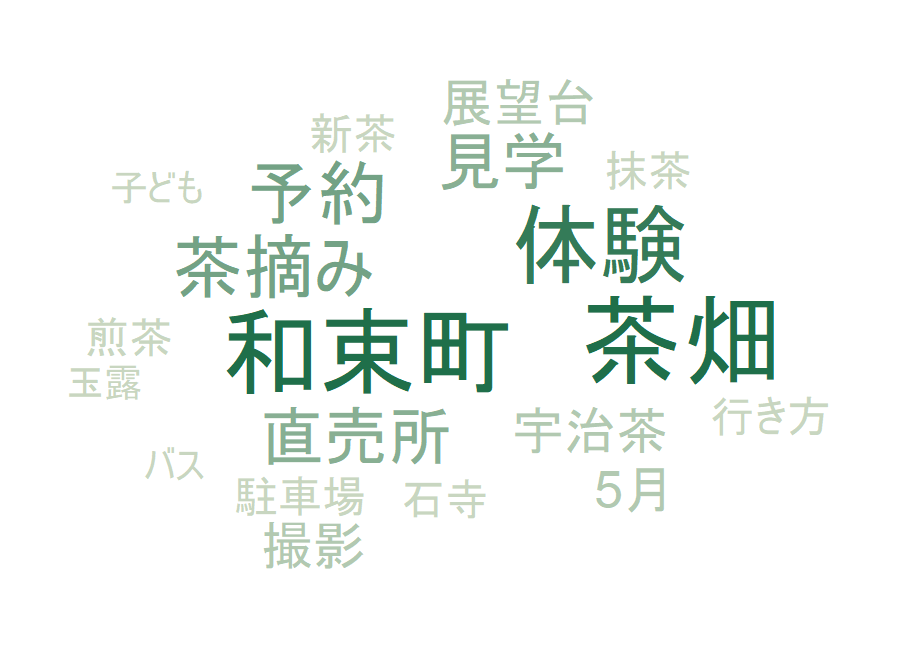
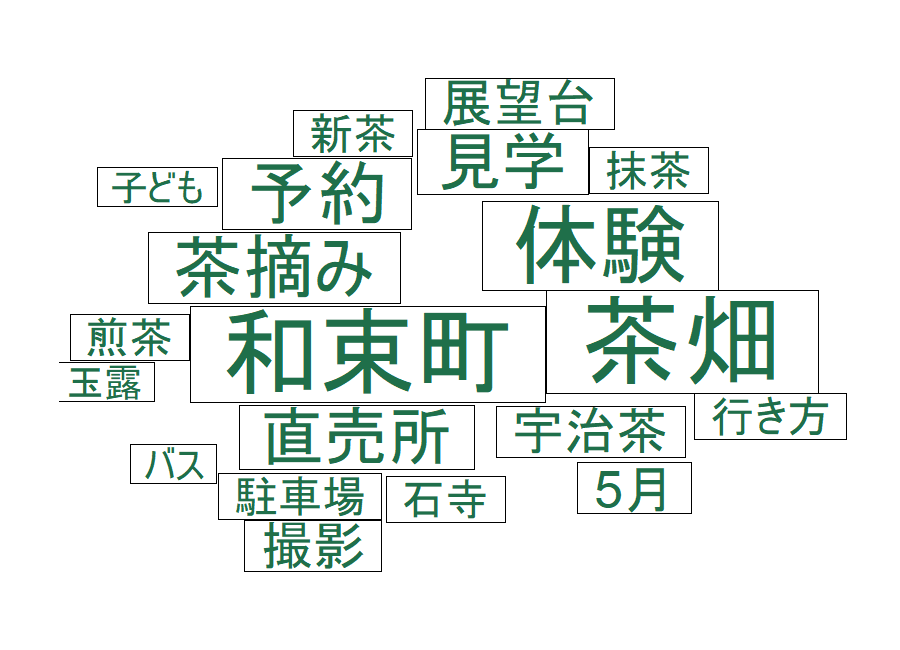
tagcloudコマンドは、語の位置と大きさを収めたtagcloudクラスのオブジェクトを返します。これをplotコマンドに渡すと、語の置き場所はそのままで、色や枠の有無だけを変えてプロットし直せます。配置は実行のたびに変わるため、同じ配置で色違いの図を並べたいときに使います。with.boxオプションをTRUEにすると、語ごとの領域が枠で示されます。
# プロットした結果を受け取る
TagRes <- tagcloud(Testdata$Tango, weights = Testdata$Kensu, col = Iro)

# 同じ配置のまま色と枠を変えてプロットし直す
plot(TagRes, col = "#1f6f4a", with.box = TRUE)
プロットした結果を受け取る
同じ配置のまま色と枠を変えてプロットし直す
| オプション | 意味 | 初期値 |
|---|---|---|
| x | tagcloudコマンドが返したオブジェクト | なし |
| family | 使う書体。語ごとに指定するベクトルも渡せる | NULL |
| add | TRUEで新しい図を作らず、今の図に重ねる | FALSE |
| with.box | TRUEで語ごとの領域を枠で示す | FALSE |
| col | 語の色。語ごとに指定するベクトルも渡せる | NULL |
| sel | 載せる語を選ぶ整数または論理値のベクトル。colとweightsも合わせて絞り込まれる | NULL |
| … | 記述なし | なし |
図の詰まり具合を確かめる:summaryコマンド
tagcloudクラスのオブジェクトの中身を要約します。語の数、weightsオプションに渡した値の範囲、語が図の面積をどれだけ占めているか(coverage)、使った配置の方法と文字の大きさの倍率が出ます。coverageの値が小さいときは、scale.multiplierオプションを大きくするか、algorithmオプションを”fill”に変えると余白が減ります。
# 語の数や詰まり具合を確認
summary(TagRes)
Object of the tagcloud class
  number of tags: 20
  value range: 2.00 - 12.00
  coverage: 57 %
  bb: (-0.16, 0.09), (1.16, 0.91)
  width: 1.32 height: 0.82
  algorithm: oval
scale: 3.260| オプション | 意味 | 初期値 |
|---|---|---|
| object | tagcloudコマンドが返したオブジェクト | なし |
| … | 記述なし | なし |
<おすすめのRに関する書籍です>
この記事が誰かの役に立ちますように。