からだにいいもの
Rで解析:統計情報を反映した作図要素でグラフを組み立てる「ggstats」パッケージの紹介
統計解析の結果を図にするとき、数値をそのまま並べるだけでは、内訳の構成比や回答の偏り、モデルが示す効果の向きが読み取りにくいことがあります。しかし、こうした情報を過不足なく盛り込んだ図をggplot2だけで組み立てるには、集計や位置調整のコードを何段も重ねる手間がかかります。
「ggstats」パッケージは、ggplot2を拡張し、統計的な情報を図に反映させるための作図要素をまとめたパッケージです。内訳の構成比を積み上げた棒グラフ、リッカート尺度の回答を中立の水準で左右に分けた図、回帰モデルの係数を信頼区間つきで並べた図などが作成できます。
また、絞り込みの過程を段階的に示すカスケード図や、調査デザインの重みを反映した作図、背景色に応じて文字色を選ぶ補助関数も利用できます。本パッケージの利用で、統計的な意図を反映した図表の作成を進めやすくなるのではないかと考えます。
パッケージバージョンは0.14.0。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>
パッケージのインストール
下記コマンドを実行してください。
作図に用いるggplot2やdplyr、patchworkなどは依存パッケージとして自動的に導入されます。ggcoef_modelを使うコマンド例では「broom.helpers」パッケージ、ggsurveyを使うコマンド例では「survey」パッケージをインストールしてください。
# パッケージのインストール
install.packages("ggstats")

# パッケージの読み込み
library("ggstats")

# コマンド例で作図に用いるggplot2を読み込み
library("ggplot2")

# 必要なパッケージのインストール
install.packages("broom.helpers")
install.packages("survey")コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
リッカート尺度とは、アンケートで「全くそう思わない」から「非常にそう思う」までの段階から1つを選ぶ回答形式を指します。
カスケード図とは、母集団から条件を重ねて絞り込む過程を、件数の減り方が分かるように段階表示した図です。調査デザインとは、層化抽出や重み付けなど、標本の抽出方法の情報をまとめたオブジェクトで、survey::svydesign()で作成します。ggstatsは、これらを扱うための作図要素や補助関数をggplot2に追加します。
以降の例では、京都府内の観光案内所が実施した来訪者アンケートを想定した擬似データを使います。嵐山・伏見・宇治・大原・天橋立の5エリアで回答を得た360件で、利用した交通手段、5段階評価の5項目(満足度・再訪意向・価格納得・案内表示・混雑感)、滞在時間、消費額、集計用の重みを含みます。
# 乱数の種を固定して結果を再現できるようにする
set.seed(2026)

# 回答者数
n <- 360

# 5段階評価の選択肢
lv <- c("全くそう思わない", "そう思わない", "どちらともいえない", "そう思う", "非常にそう思う")

# 指定した比率で5段階評価を1項目分つくる関数
mk <- function(prob) factor(sample(lv, n, replace = TRUE, prob = prob), levels = lv)

# 来訪者アンケートを模したデータフレーム
df <- data.frame(
  # 回答を得た観光エリア
  エリア = factor(
    sample(c("嵐山", "伏見", "宇治", "大原", "天橋立"), n, replace = TRUE,
           prob = c(3, 3, 2, 1, 1)),
    levels = c("嵐山", "伏見", "宇治", "大原", "天橋立")
  ),
  # 主に利用した交通手段
  交通手段 = factor(
    sample(c("鉄道", "路線バス", "自家用車", "レンタサイクル"), n, replace = TRUE,
           prob = c(4, 2, 3, 1)),
    levels = c("鉄道", "路線バス", "自家用車", "レンタサイクル")
  ),
  # 回答者の年代
  年代 = factor(
    sample(c("20代", "30代", "40代", "50代", "60代以上"), n, replace = TRUE),
    levels = c("20代", "30代", "40代", "50代", "60代以上")
  ),
  # 5段階評価の各項目
  満足度 = mk(c(1, 2, 3, 6, 5)),
  再訪意向 = mk(c(1, 2, 3, 5, 6)),
  価格納得 = mk(c(2, 4, 5, 4, 2)),
  案内表示 = mk(c(1, 3, 4, 5, 3)),
  混雑感 = mk(c(1, 2, 3, 5, 6)),
  # 滞在時間(時間)
  滞在時間 = round(rgamma(n, shape = 4, scale = 0.9), 1),
  # 消費額(円)
  消費額 = round(rnorm(n, mean = 5200, sd = 1800)),
  # 集計に用いる重み
  重み = round(runif(n, 80, 140))
)

# 消費額の下限を500円にする
df$消費額 <- pmax(df$消費額, 500)
[構成比を積み上げた棒グラフの描画]:geom_prop_barコマンド
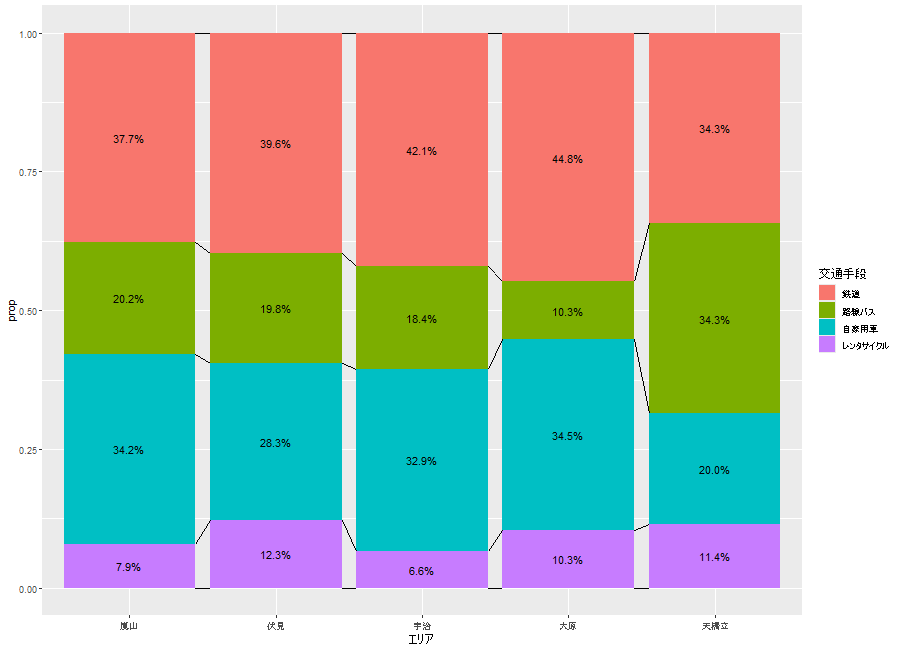
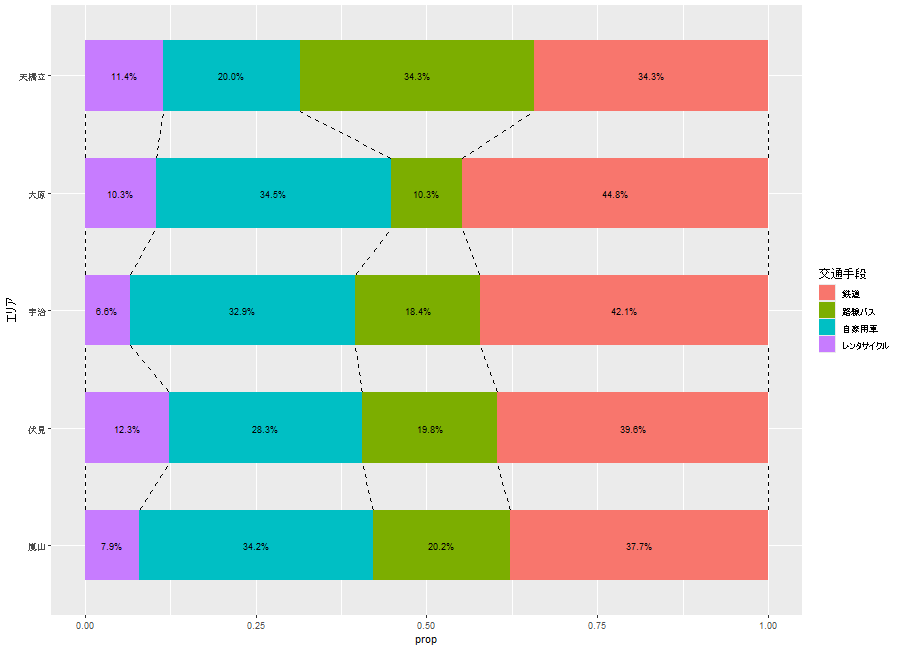
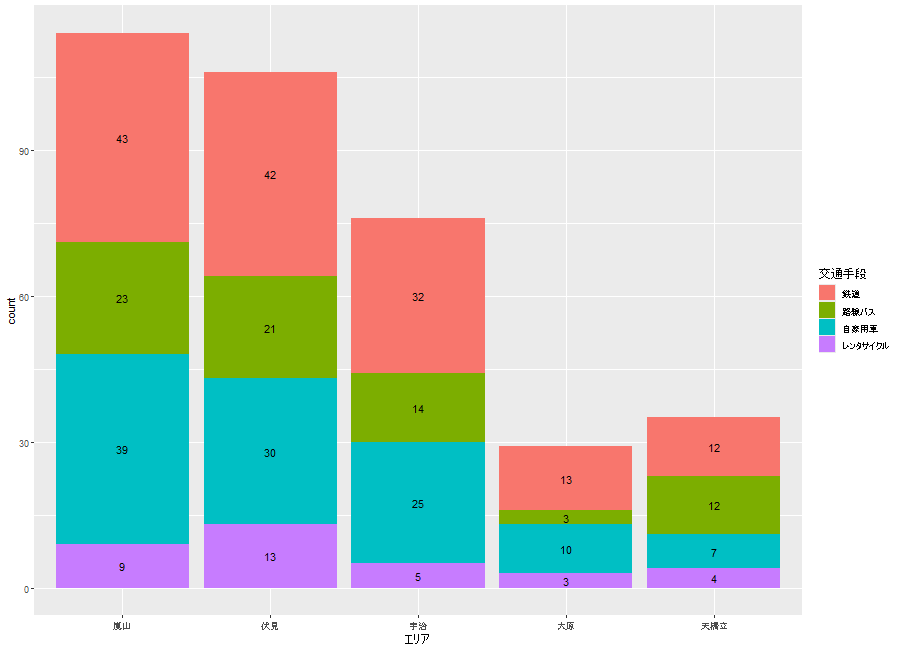
カテゴリごとに内訳の構成比を計算し、100%に揃えて積み上げた棒グラフを描きます。geom_prop_text()で各区画に割合のラベルを、geom_prop_connector()で隣り合う棒の区画の境目をつなぐ線をプロットできます。
| オプション | 意味 | 初期値 |
|---|---|---|
| mapping | aes() で作成する審美的マッピングの組。inherit.aes = TRUE のとき既定のマッピングと統合される | NULL |
| data | このレイヤーで表示するデータ。NULL のとき ggplot() 呼び出しのデータを継承する | NULL |
| position | データに適用する位置調整 | “stack” |
| … | ggplot2::geom_bar()、ggplot2::geom_text()、geom_bar_connector() へ渡す追加の引数 | なし |
| width | バーの幅 | 0.9 |
| complete | 観測されなかった水準について統計量を補完する審美的属性の名前 | NULL |
| default_by | by 属性が無いときに分母の算出に使う属性名。NULL または “total” で全体に対する割合 | “x” |
# エリアごとに、利用した交通手段の構成比を積み上げる
ggplot(df) +
  aes(x = エリア, fill = 交通手段) +
  geom_prop_bar() +
  geom_prop_text() +
  geom_prop_connector()

# 横向きにし、バーの幅と線種を変える
ggplot(df) +
  aes(y = エリア, fill = 交通手段) +
  geom_prop_bar(width = 0.6) +
  geom_prop_text(size = 3) +
  geom_prop_connector(width = 0.6, linetype = "dashed")

# 割合ではなく実数の件数をラベルにする
ggplot(df) +
  aes(
    x = エリア,
    fill = 交通手段,
    y = after_stat(count),
    label = after_stat(count)
  ) +
  geom_prop_bar() +
  geom_prop_text()
・エリアごとに、利用した交通手段の構成比を積み上げる
・横向きにし、バーの幅と線種を変える
・割合ではなく実数の件数をラベルにする
[回帰モデルの係数のプロット]:ggcoef_modelコマンド
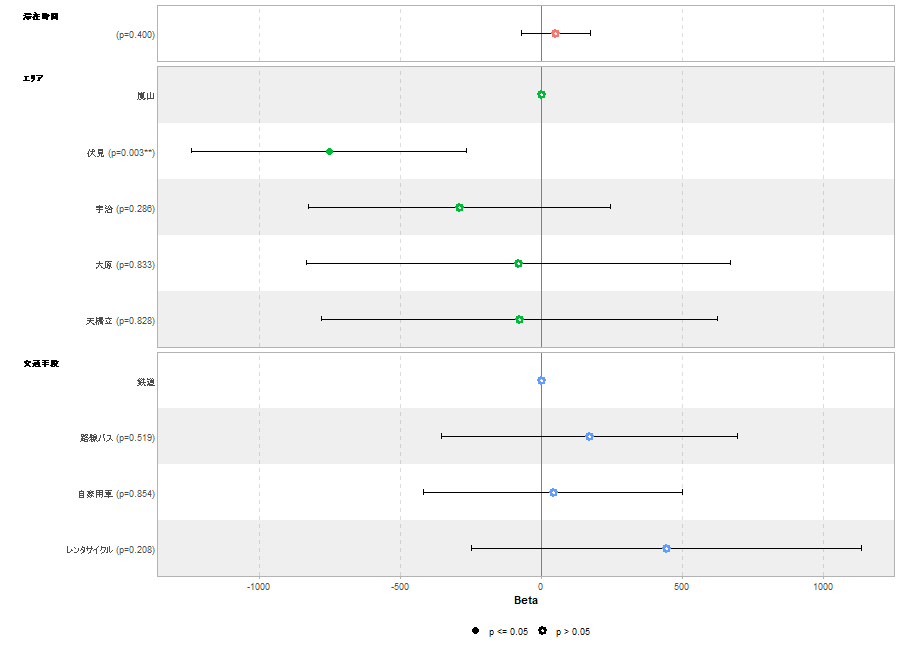
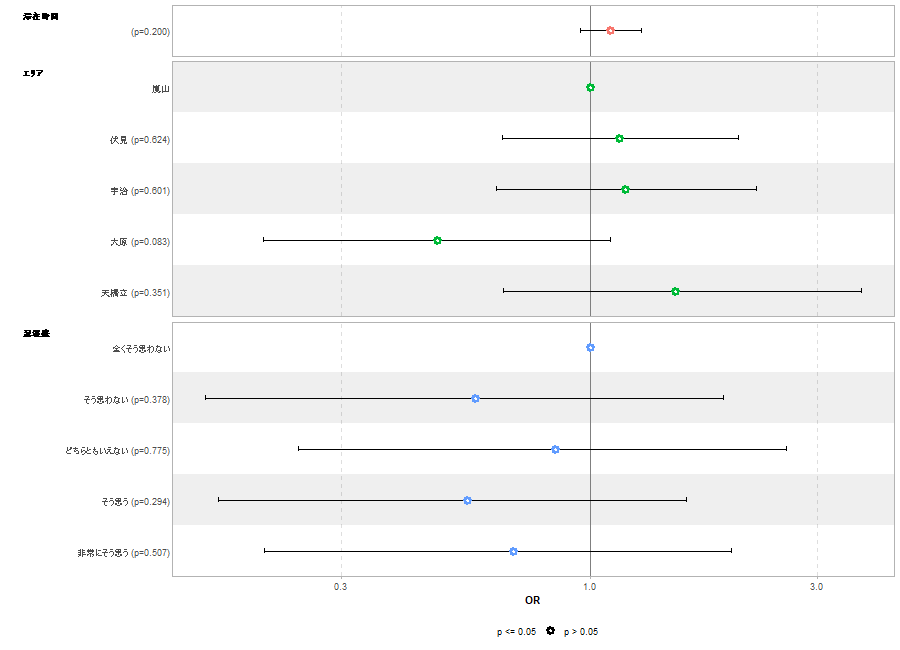
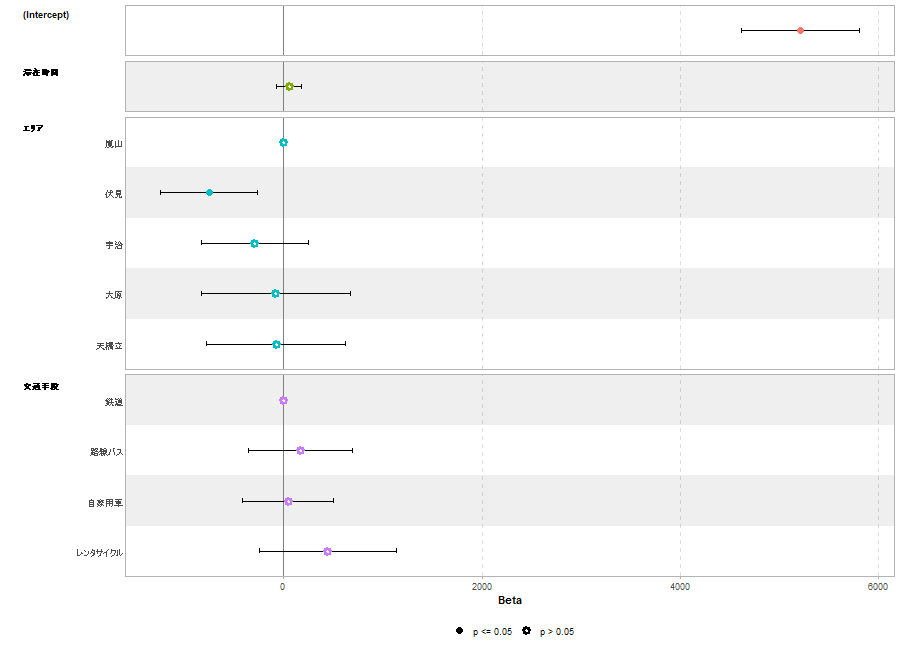
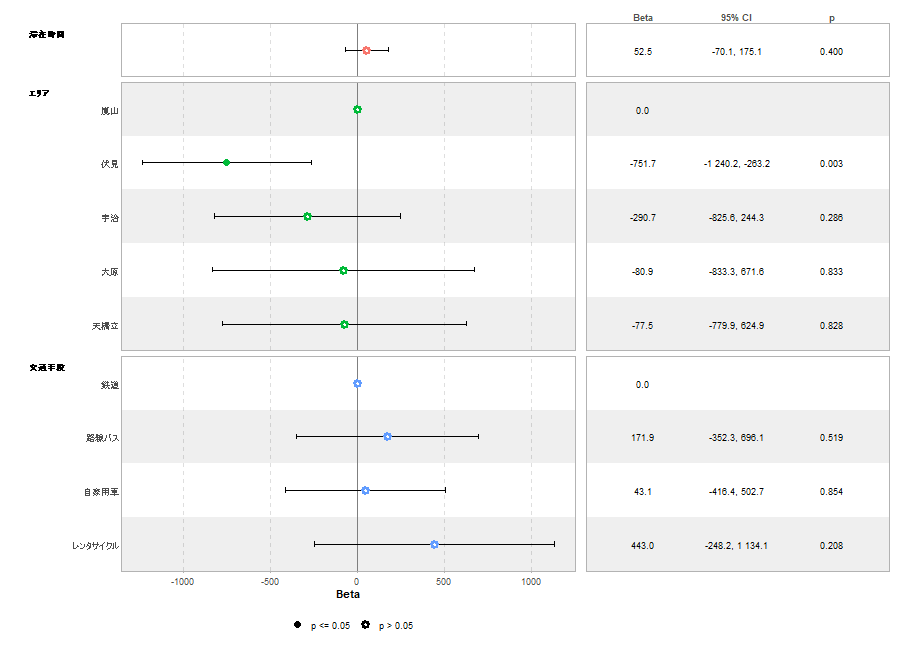
回帰モデルのオブジェクトを渡すと、各項の係数(またはその指数変換値)を、信頼区間を表す横線つきの点で並べた図を描きます。整形処理にbroom.helpersを用いるため、事前の導入が必要です。ggcoef_table()を使うと、係数の一覧表を図の横に添えられます。
| オプション | 意味 | 初期値 |
|---|---|---|
| model | 回帰モデルのオブジェクト | なし |
| tidy_fun | 整形処理に用いる関数を差し替える指定 | broom.helpers::tidy_with_broom_or_parameters |
| tidy_args | broom.helpers::tidy_plus_plus() と tidy_fun へ渡す追加の引数 | NULL |
| conf.int | 信頼区間を計算するかどうか | TRUE |
| conf.level | 信頼区間の信頼水準。0 より大きく 1 より小さい値 | 0.95 |
| exponentiate | TRUE で x 軸を対数スケールにし係数を指数変換する | FALSE |
| variable_labels | 変数ラベルを差し替える名前付きリストまたはベクトル | NULL |
| term_labels | 項ラベルを差し替える名前付きリストまたはベクトル | NULL |
| interaction_sep | 交互作用項の区切り文字 | ” * “ |
| categorical_terms_pattern | カテゴリ項のラベルに用いる glue パターン | “{level}” |
| add_reference_rows | 参照水準の行を追加するかどうか | TRUE |
| no_reference_row | 参照行を追加しない変数の指定 | NULL |
| intercept | 切片を含めるかどうか | FALSE |
| include | 含める変数の指定 | dplyr::everything() |
| group_by | グループ化に用いる 1 個以上の変数。NULL で強制的にグループ化を解除する | broom.helpers::auto_group_by() |
| group_labels | グループのラベルを差し替える名前付きベクトル | NULL |
| add_pairwise_contrasts | 総当たり対比を追加するかどうか | FALSE |
| pairwise_variables | 総当たり対比を追加する変数の指定 | broom.helpers::all_categorical() |
| keep_model_terms | 総当たり対比を加えた変数について元の項も残すかどうか | FALSE |
| pairwise_reverse | 対比の向きを “pairwise” にするか “revpairwise” にするか | TRUE |
| emmeans_args | 総当たり対比の計算時に emmeans::emmeans() へ渡す追加の引数のリスト | list() |
| significance | 係数が 0(指数変換時は 1)と有意に異なるとみなす水準。NULL で強調しない | 1 – conf.level |
| significance_labels | 有意性の区分に付ける任意のラベル | NULL |
| show_p_values | ラベルに p 値を添えるかどうか | TRUE |
| signif_stars | ラベルに有意性を表す星印を添えるかどうか | TRUE |
| return_data | 作図の代わりに作図用データフレームを返すかどうか | FALSE |
| … | ggcoef_plot() へ渡す追加の引数 | なし |
# 消費額を説明する重回帰モデル
mod_spend <- lm(消費額 ~ 滞在時間 + エリア + 交通手段, data = df)

# 係数を信頼区間つきで並べる
ggcoef_model(mod_spend)

# 再訪意向が「そう思う」以上かどうかを表す論理値の列
df$再訪 <- df$再訪意向 %in% c("そう思う", "非常にそう思う")

# 再訪の有無をロジスティック回帰で説明する
mod_return <- glm(再訪 ~ 滞在時間 + エリア + 混雑感, data = df, family = binomial)

# 係数をオッズ比に指数変換して表示する
ggcoef_model(mod_return, exponentiate = TRUE)

# 切片を含め、p値と星印の表示を消す
ggcoef_model(
  mod_spend,
  intercept = TRUE,
  show_p_values = FALSE,
  signif_stars = FALSE
)

# 係数の一覧表を図の横に添える
ggcoef_table(mod_spend)
・係数を信頼区間つきで並べる
・係数をオッズ比に指数変換して表示する
・切片を含め、p値と星印の表示を消す
・係数の一覧表を図の横に添える
<おすすめのRに関する書籍です>

 www.amazon.co.jp
[リッカート尺度項目の一括プロット:gglikertコマンド
同じ選択肢を持つ複数の評価項目をまとめて渡すと、項目ごとに回答の構成比を計算し、中立の水準を境に否定側と肯定側へ分けて積み上げた図を描きます。左右の端には否定・肯定それぞれの合計割合がプロットされます。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | データフレーム、その拡張(tibble など)、または survey のデザインオブジェクト | なし |
| include | 含める変数。tidy-select 構文が使える | dplyr::everything() |
| weights | 重み付けに用いる変数名。tidy-select 構文が使える | NULL |
| y | y 軸に描く変数の名前(.question をファセットに割り当てたときに使う) | “.question” |
| variable_labels | 変数ラベルを差し替える名前付きリストまたはベクトル | NULL |
| sort | 回答内容に応じて項目を並べ替えるか。”none”、”ascending”、”descending” のいずれか | c(“none”, “ascending”, “descending”) |
| sort_method | 並べ替えの方法。”prop” は中央水準より上の割合、”prop_lower” は下の割合、”mean” は平均スコア、”median” は中央値で並べ替える | c(“prop”, “prop_lower”, “mean”, “median”) |
| sort_prop_include_center | “prop” で並べ替え、水準数が奇数のとき、中央水準の半分を割合の計算に含めるかどうか | totals_include_center |
| factor_to_sort | sort が “none” 以外のとき並べ替える因子列の名前。既定は include で渡した質問群 | “.question” |
| exclude_fill_values | 表示しない値(割合の計算には用いる)のベクトル | NULL |
| cutoff | 負の側(左または下)に表示するカテゴリ数。小数も指定できる。NULL でカテゴリ数の半分 | NULL |
| data_fun | gglikert_data() の最後で生成データに適用する任意の関数 | NULL |
| add_labels | 割合のラベルを図に加えるかどうか | TRUE |
| labels_size | 割合ラベルの大きさ | 3.5 |
| labels_color | 割合ラベルの色。”auto” で背景色から hex_bw() が決める | “auto” |
| labels_accuracy | 割合の丸めの精度 | 1 |
| labels_suffix | 割合の後ろに表示する文字 | “%” |
| labels_hide_below | この値を下回る割合のラベルを隠す | 0.05 |
| add_totals | 肯定・否定の合計割合を図に加えるか。”left” または “right” で片側のみ | TRUE |
| totals_size | 合計割合の大きさ | labels_size |
| totals_color | 合計割合の色 | “black” |
| totals_accuracy | 合計割合の丸めの精度 | labels_accuracy |
| totals_suffix | 合計割合の後ろに表示する文字 | labels_suffix |
| totals_fontface | 合計割合のフォントの書体 | “bold” |
| totals_include_center | 水準数が奇数のとき、中央水準の半分を合計割合に加えるかどうか | FALSE |
| totals_hjust | x 軸方向の合計ラベルの位置調整 | 0.1 |
| y_reverse | y 軸を反転させるかどうか | TRUE |
| y_label_wrap | y 軸ラベルの 1 行あたりの文字数 | 50 |
| reverse_likert | TRUE で既定の積み上げ順を反転させる | FALSE |
| width | バーの幅 | 0.9 |
| facet_rows | ggplot2::vars() で囲んだ、行方向のファセットを定める変数群 | NULL |
| facet_cols | ggplot2::vars() で囲んだ、列方向のファセットを定める変数群 | NULL |
| facet_label_wrap | ファセットラベルの 1 行あたりの文字数 | 50 |
| symmetric | x 軸を左右対称にするかどうか | FALSE |
# 5段階評価の5項目だけを取り出す
items <- df[, c("満足度", "再訪意向", "価格納得", "案内表示", "混雑感")]

# 基本のリッカート図
gglikert(items)

# 肯定側の割合が多い順に並べ、割合ラベルを消す
gglikert(items, sort = "descending", add_labels = FALSE)

# 中央の「どちらともいえない」を集計から外す
gglikert(items, exclude_fill_values = "どちらともいえない")

# 項目名を説明的なラベルに置き換える
gglikert(
  items,
  variable_labels = c(
    満足度 = "全体の満足度",
    再訪意向 = "また訪れたい",
    価格納得 = "価格は妥当だった",
    案内表示 = "案内表示は分かりやすい",
    混雑感 = "混雑を感じた"))
・基本のリッカート図
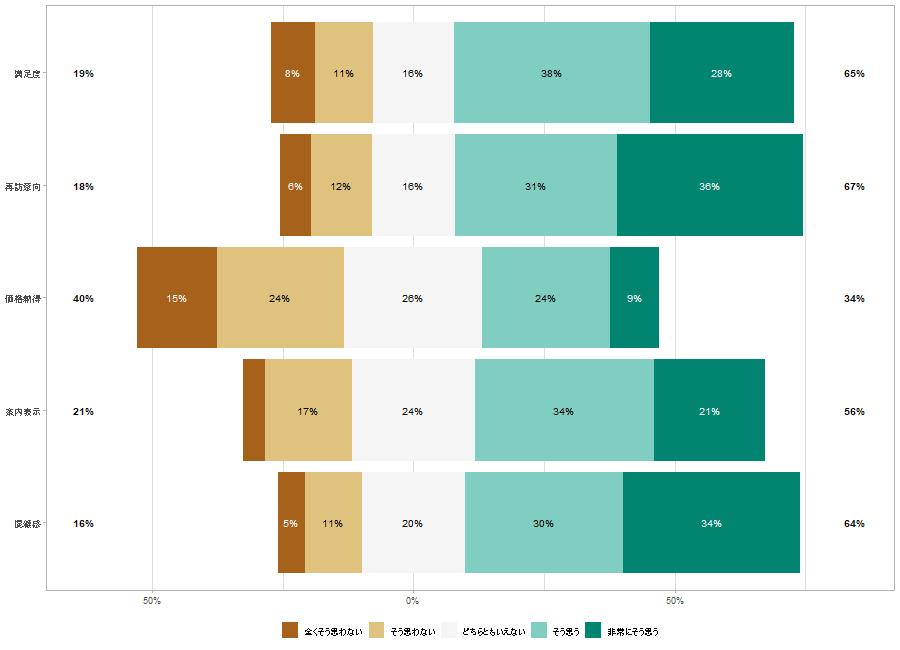
・肯定側の割合が多い順に並べ、割合ラベルを消す
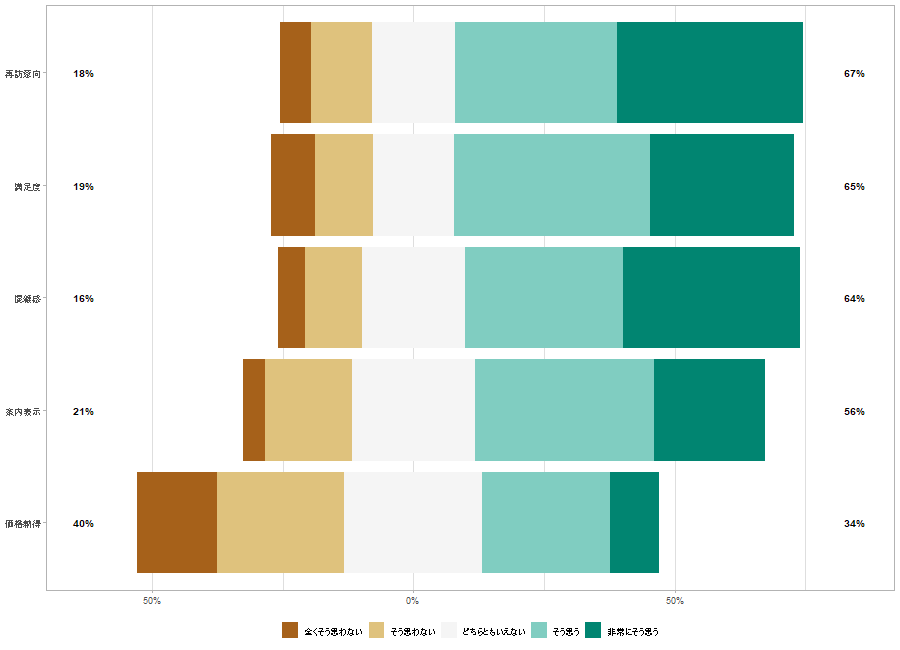
・中央の「どちらともいえない」を集計から外す
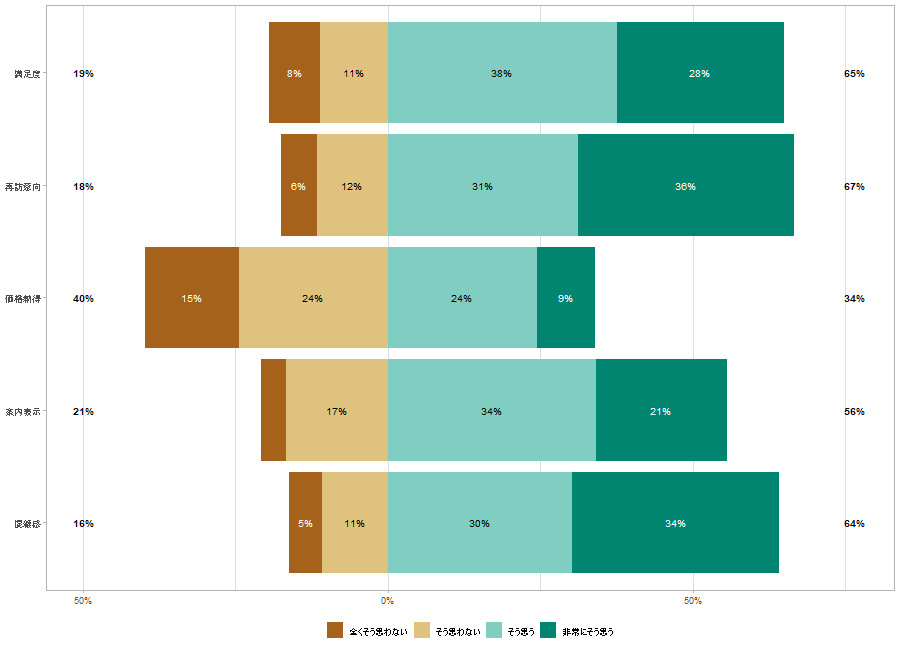
・項目名を説明的なラベルに置き換える
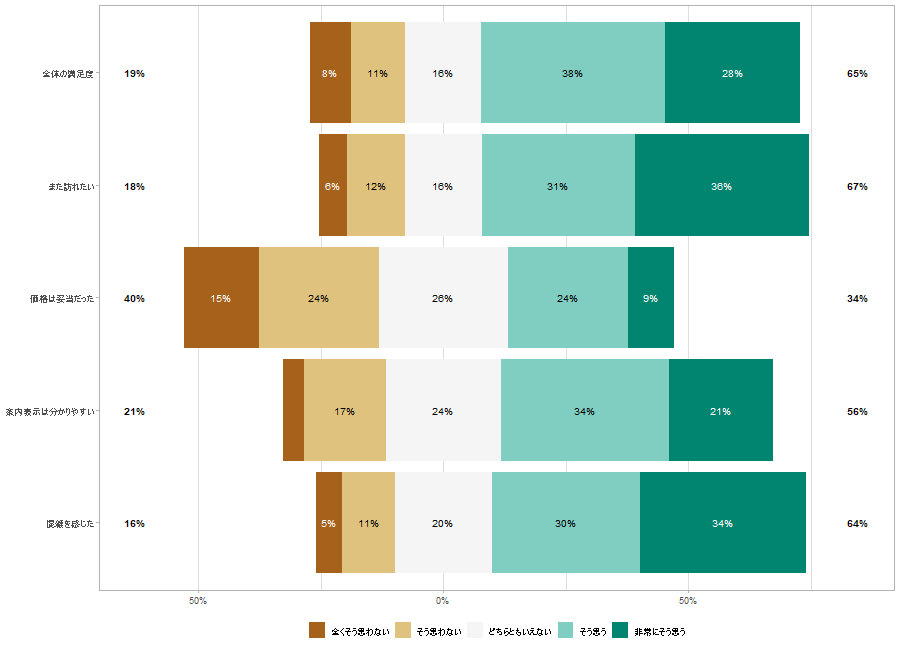
[棒や点をつなぐ連結線のプロット]:geom_connectorコマンド
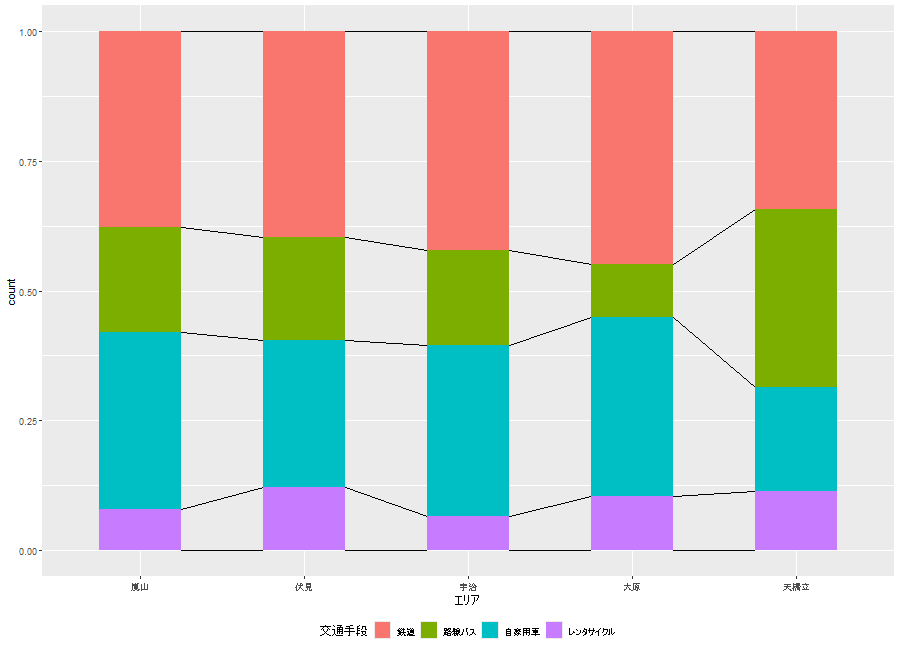
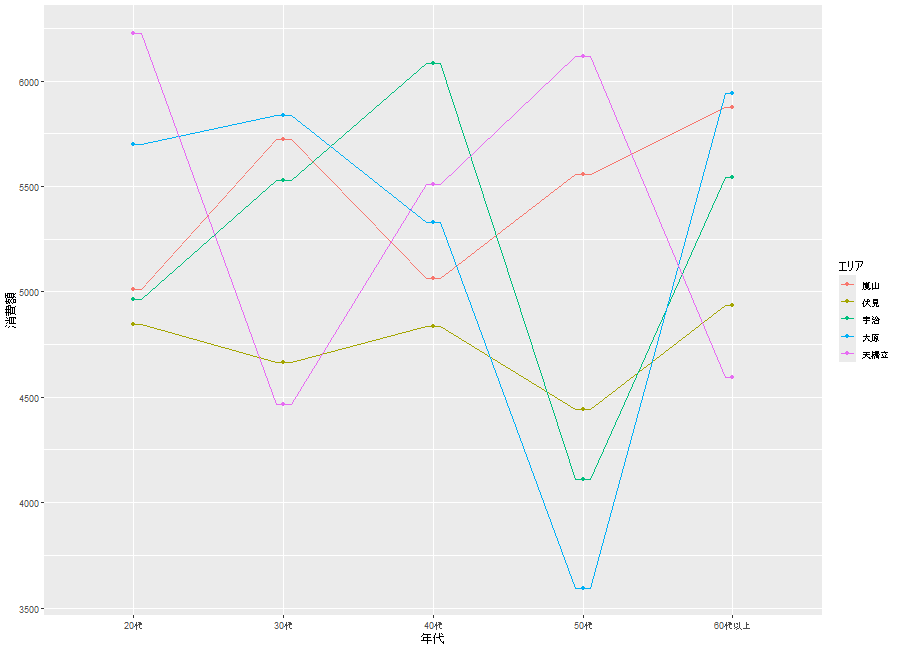
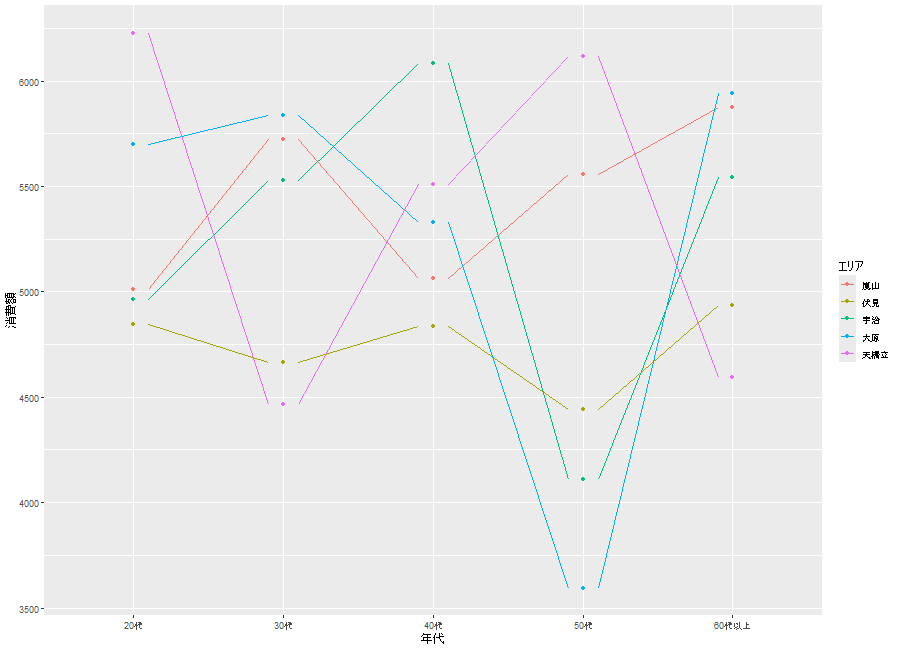
隣り合う棒や点を階段状の線でつなぎます。棒グラフの区画をつなぐgeom_bar_connector()と、任意の点をつなぐgeom_connector()があり、widthで線の水平方向の広がりを、continuousで線を連続させるかどうかを調整します。
| オプション | 意味 | 初期値 |
|---|---|---|
| mapping | aes() で作成する審美的マッピングの組 | NULL |
| data | このレイヤーで表示するデータ。NULL のとき ggplot() 呼び出しのデータを継承する | NULL |
| stat | データに適用する統計変換 | “identity” |
| position | データに適用する位置調整 | “identity” |
| width | バーの幅 | 0.1 |
| continuous | 連結の線分を連続にするかどうか | FALSE |
| na.rm | FALSE で欠測値を警告とともに除き、TRUE で警告なく除く | FALSE |
| orientation | レイヤーの向き。NA で審美的マッピングから自動判定する | NA |
| show.legend | このレイヤーを凡例に含めるかどうか | NA |
| inherit.aes | FALSE で既定の審美的属性を継承せず上書きする | TRUE |
| … | layer() の params へ渡すその他の引数。固定の色や線幅などの静的な審美的属性を含む | なし |
# エリア別の交通手段の構成を100%積み上げで描く
ggplot(df) +
  aes(x = エリア, fill = 交通手段) +
  geom_bar(width = 0.5, position = "fill") +
  # 区画の境目を細い線でつなぐ
  geom_bar_connector(width = 0.5, position = "fill", linewidth = 0.25) +
  theme(legend.position = "bottom")

# 年代ごとの平均消費額をエリア別に集計する
tbl <- aggregate(消費額 ~ 年代 + エリア, data = df, FUN = mean)

# 点を連続した線でつなぐ
ggplot(tbl) +
  aes(x = 年代, y = 消費額, colour = エリア, group = エリア) +
  geom_connector(continuous = TRUE) +
  geom_point()

# 連結線の水平方向の広がりを狭める
ggplot(tbl) +
  aes(x = 年代, y = 消費額, colour = エリア, group = エリア) +
  geom_connector(width = 0.2) +
  geom_point()
・エリア別の交通手段の構成を100%積み上げで描く
・点を連続した線でつなぐ
・連結線の水平方向の広がりを狭める
<おすすめのRに関する書籍です>
[中立を境に左右へ分けた棒グラフのプロット]:geom_divergingコマンド
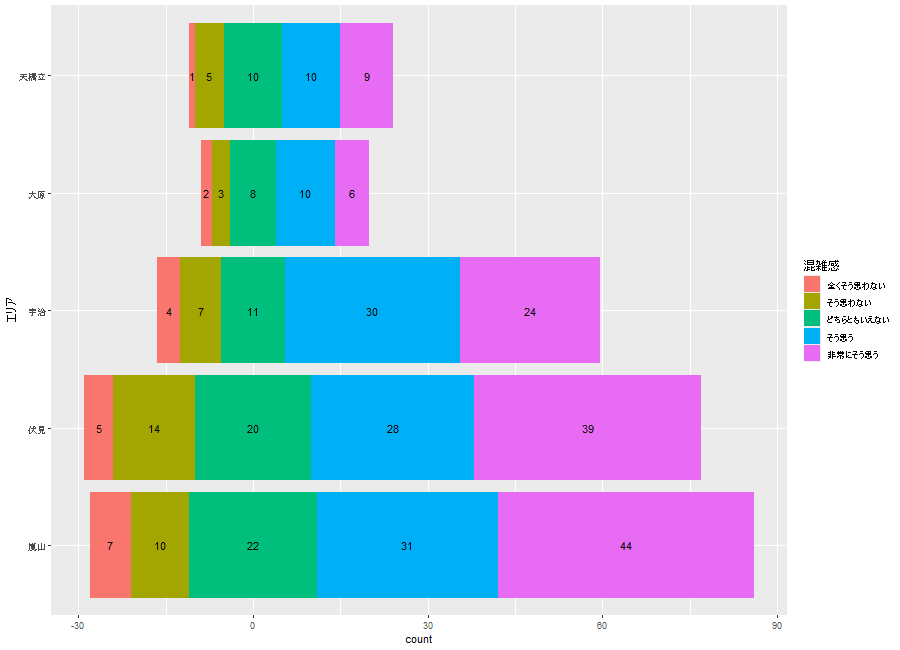
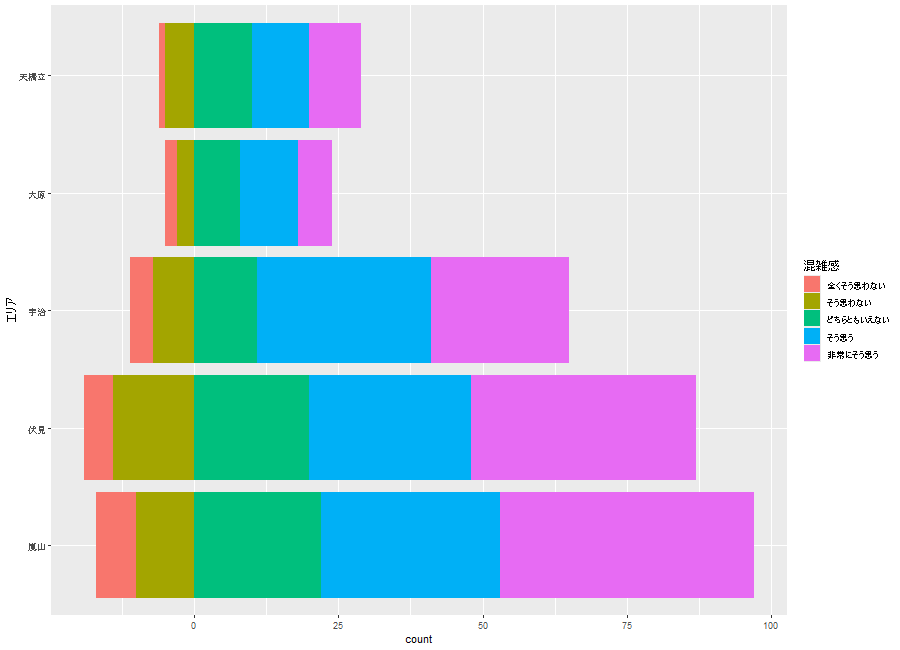
順序のあるカテゴリを、中立の水準を境に否定側を左(下)へ、肯定側を右(上)へ分けて積み上げます。位置調整のposition_diverging()にcutoffを渡すと、左右を分ける境目の位置を動かせます。geom_likert()は割合に、geom_diverging()は件数に基づいて同様の積み上げを行います。
| オプション | 意味 | 初期値 |
|---|---|---|
| mapping | 審美的マッピングの組(任意) | NULL |
| data | このレイヤーで表示するデータ | NULL |
| position | データに適用する位置調整 | “diverging” |
| … | ggplot2::geom_bar() へ渡すその他の引数 | なし |
| complete | 観測されなかった値を補完する審美的属性 | “fill” |
| default_by | 既定で分母を決める審美的属性の名前 | “total” |
# 「混雑を感じた」への回答をエリア別に左右へ分ける
ggplot(df) +
  aes(y = エリア, fill = 混雑感) +
  geom_diverging() +
  geom_diverging_text()

# 否定側の2区分までを左に寄せる位置に境目を動かす
ggplot(df) +
  aes(y = エリア, fill = 混雑感) +
  geom_diverging(position = position_diverging(cutoff = 2))

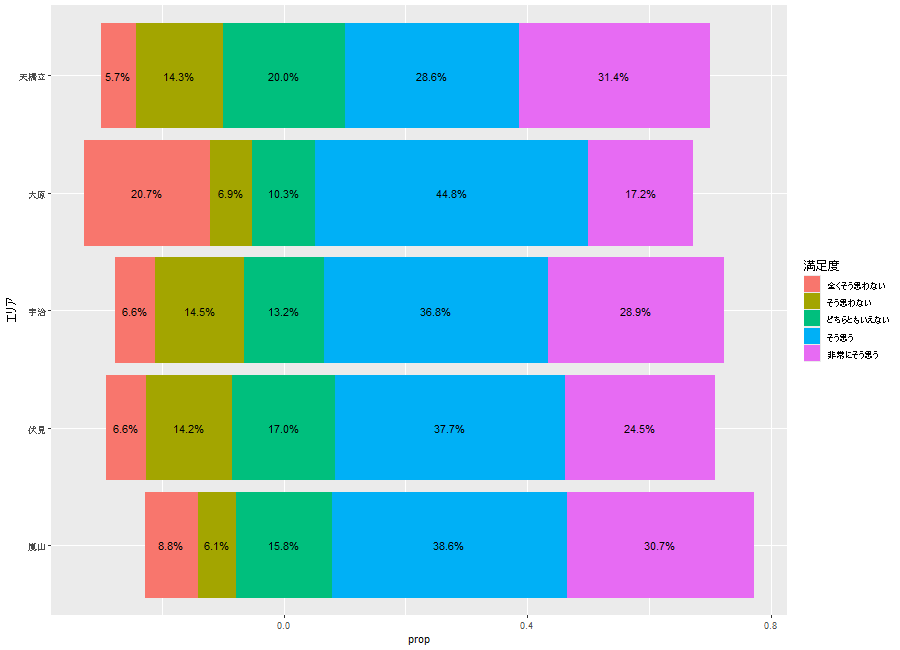
# 満足度をリッカート型の位置調整で積み上げる
ggplot(df) +
  aes(y = エリア, fill = 満足度) +
  geom_likert() +
  geom_likert_text()
・「混雑を感じた」への回答をエリア別に左右へ分ける
・否定側の2区分までを左に寄せる位置に境目を動かす
・満足度をリッカート型の位置調整で積み上げる
[絞り込みの過程を示すカスケード図のプロット]:ggcascadeコマンド
データと、状態を表す名前つきの条件式を複数渡すと、各条件を満たす件数を段階的に示す図をプロットします。左から右へ、条件を重ねるたびに件数がどれだけ減るかを追えます。分割表示にはpatchworkを内部で用います。
| オプション | 意味 | 初期値 |
|---|---|---|
| .data | データフレーム、またはその拡張(tibble など) | なし |
| … | 描き分ける状態を定義する名前と条件の組 | なし |
| .weights | 任意の重み。1 変数だけを選ぶ | NULL |
| .by | カスケードの計算をグループ化し、ファセットを生成する変数。複数選ぶときは dplyr::pick() を使う | NULL |
| .nrow | ファセットの行数 | NULL |
| .ncol | ファセットの列数 | NULL |
| .add_n | 観測数を表示するかどうか | TRUE |
| .text_size | ラベルの大きさ。ggplot2::geom_text() へ渡す | 4 |
| .arrows | 状態のあいだに矢印を表示するかどうか | TRUE |
# 全体 → 滞在3時間超 → さらに消費額5千円超、と絞り込む
df |>
  ggcascade(
    全体 = TRUE,
    "3時間超" = 滞在時間 > 3,
    "3時間超かつ5千円超" = 滞在時間 > 3 & 消費額 > 5000  )

# エリアごとに分け、矢印を消してラベルを小さくする
df |>
  ggcascade(
    全体 = TRUE,
    "3時間超" = 滞在時間 > 3,
    "3時間超かつ5千円超" = 滞在時間 > 3 & 消費額 > 5000,
    .by = エリア,
    .ncol = 3,
    .arrows = FALSE,
    .text_size = 3)
・全体 → 滞在3時間超 → さらに消費額5千円超、と絞り込む
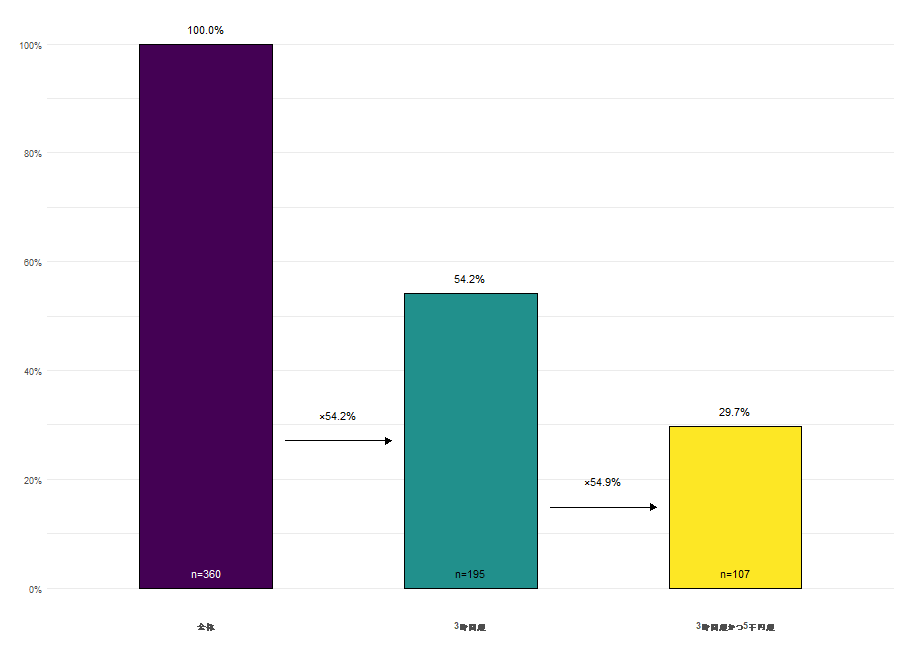
・エリアごとに分け、矢印を消してラベルを小さくする
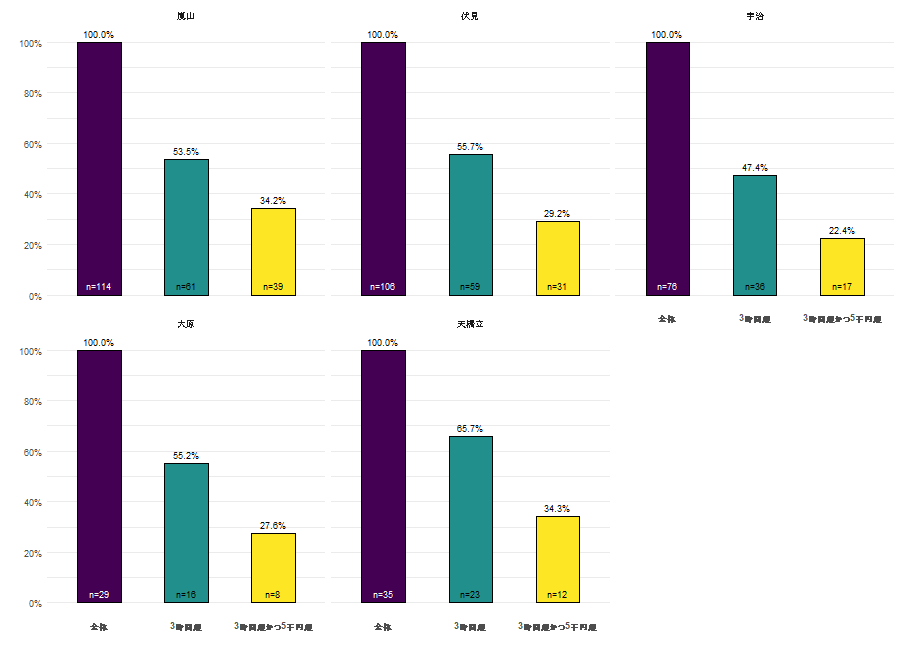
[調査デザインを反映したプロット]:ggsurveyコマンド
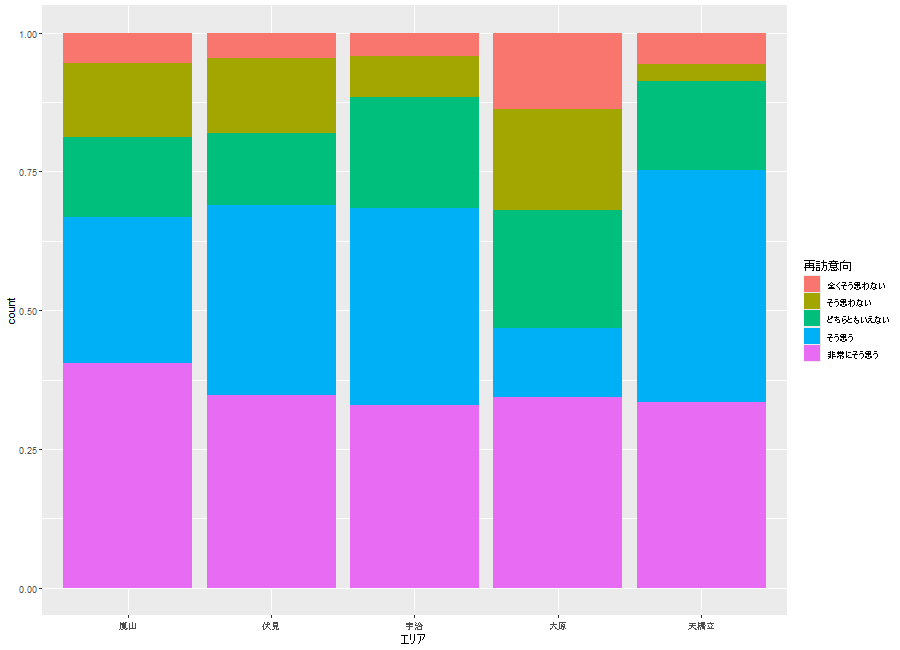
survey::svydesign()で作成した調査デザインのオブジェクトを渡すと、重みを反映して展開したデータを持つggplotオブジェクトを返します。以降はaes()やgeom_*()を通常どおり足していけます。surveyパッケージの導入が必要です。
| オプション | 意味 | 初期値 |
|---|---|---|
| design | survey::svydesign() などで作成した調査デザインのオブジェクト | NULL |
| mapping | 作図に用いる既定の審美的マッピング。ggplot2::aes() で作成する | NULL |
| … | メソッドへ渡すその他の引数。現在は未使用 | なし |
# surveyパッケージを読み込む
library("survey")

# 各回答に集計用の重みを付けた調査デザイン
design <- svydesign(ids = ~1, weights = ~重み, data = df)

# 重みを反映してエリア別の再訪意向の構成比をプロット
ggsurvey(design) +
  aes(x = エリア, fill = 再訪意向) +
  geom_bar(position = "fill")

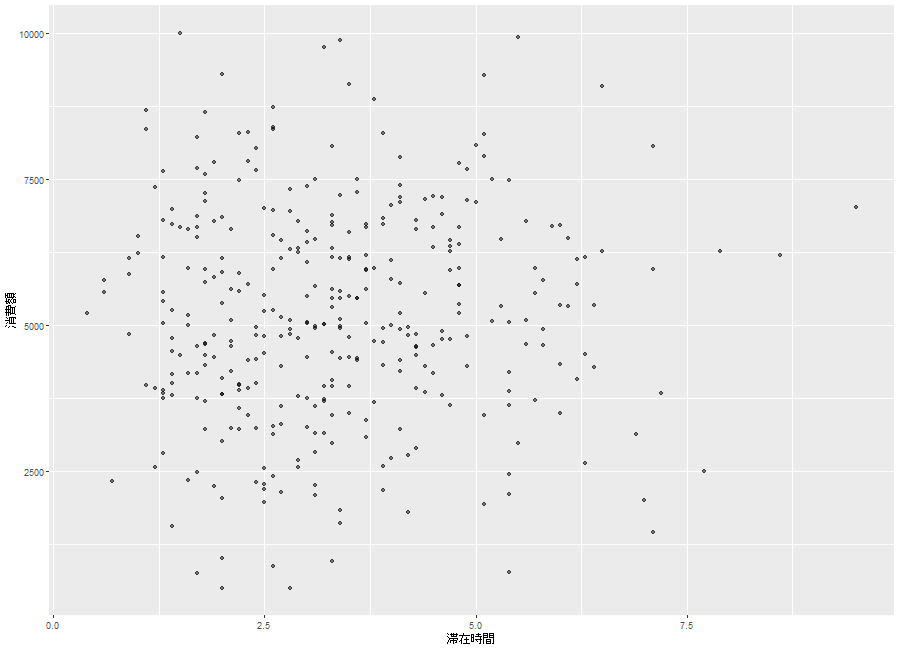
# 重みを反映した滞在時間と消費額の散布図
ggsurvey(design) +
  aes(x = 滞在時間, y = 消費額) +
  geom_point(alpha = 0.5)
・重みを反映してエリア別の再訪意向の構成比をプロット
・重みを反映した滞在時間と消費額の散布図
[背景色に応じた文字色の判定]:hex_bwコマンド
16進表記の背景色を渡すと、その上に文字を重ねたときに読みやすい方の色として、黒(#000000)か白(#ffffff)を返します。ベクトルを渡すとまとめて判定します。after_scale()と組み合わせると、塗り分けた区画ごとに文字色を切り替えられます。
| オプション | 意味 | 初期値 |
|---|---|---|
| hex_code | 16 進表記で指定する背景色 | なし |
# 背景色を1つ渡して、読みやすい文字色を得る
hex_bw("#1b9e77")
[1] "#000000"

# ベクトルでまとめて判定する
hex_bw(c("#2c7fb8", "#fee08b", "#d73027"))
[1] "#ffffff" "#000000" "#ffffff"
# 積み上げ棒の各区画に、背景色に応じた文字色で件数を重ねる
ggplot(df) +
aes(x = エリア, fill = 交通手段, label = after_stat(count)) +
geom_bar() +
geom_text(
mapping = aes(colour = after_scale(hex_bw(.data$fill))),
position = position_stack(0.5),
stat = "count",
size = 3)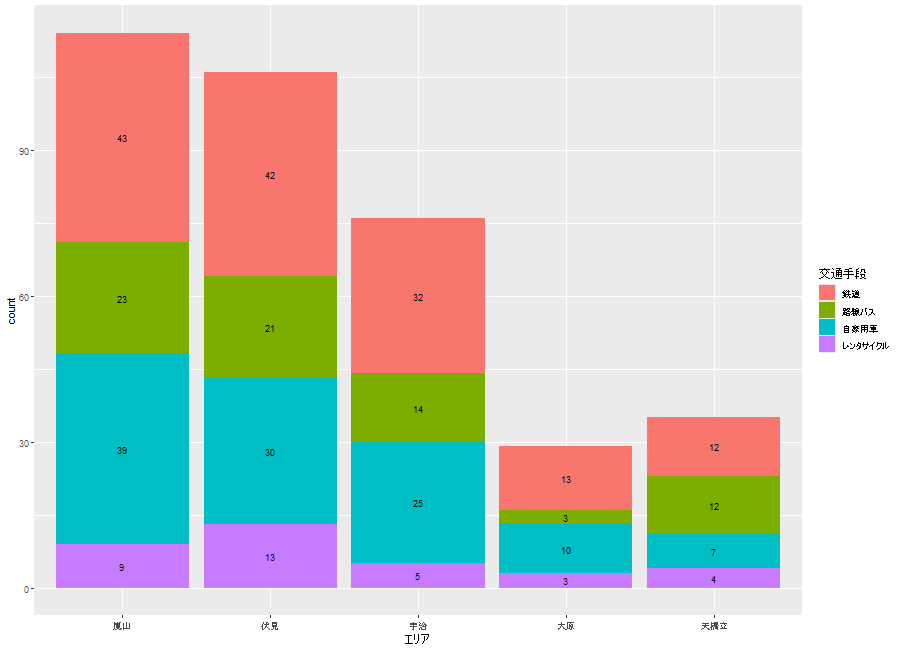
<おすすめのRに関する書籍です>
この記事が誰かの役に立ちますように。