からだにいいもの
Rで解析:差分発現解析の結果からボルケーノプロットを作る「ggvolc」パッケージ
「ggvolc」パッケージは、遺伝子ごとの発現量の差と有意性をまとめた差分発現解析の結果から、ボルケーノプロットを作成できるパッケージです。渡すのは、遺伝子名・log2倍率変化・p値の列を持つデータフレームか、DESeq2、edgeR、limmaの結果オブジェクトで、列名はそれぞれの形式から自動で読み取ります。注目する遺伝子に名前を付けたり、複数の比較を並べたり、遺伝子の一覧表をプロットの下に添えたりもできます。プロットはggplot2で作られるため、ggplot2の書式で手を加えられます。RNA-seqの解析結果を、手早く報告用の図にまとめられるのではないかと考えます。
パッケージバージョンは0.4.0。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>
パッケージのインストール
下記コマンドを実行してください。
# パッケージのインストール
install.packages("ggvolc")

# パッケージの読み込み
library("ggvolc")
Warning message:
package 'ggvolc' was built under R version 4.6.2
Welcome to ggvolc version 0.4.0 !

                                888
                                888
                                888
 .d88b.   .d88b.  888  888  .d88b.  888  .d8888b
d88P"88b d88P"88b 888  888 d88""88b 888 d88P"
888  888 888  888 Y88  88P 888  888 888 888
Y88b 888 Y88b 888  Y8bd8P  Y88..88P 888 Y88b.
 "Y88888  "Y88888   Y88P    "Y88P"  888  "Y8888P
     888      888
Y8b d88P Y8b d88P
 "Y88P"   "Y88P"
コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
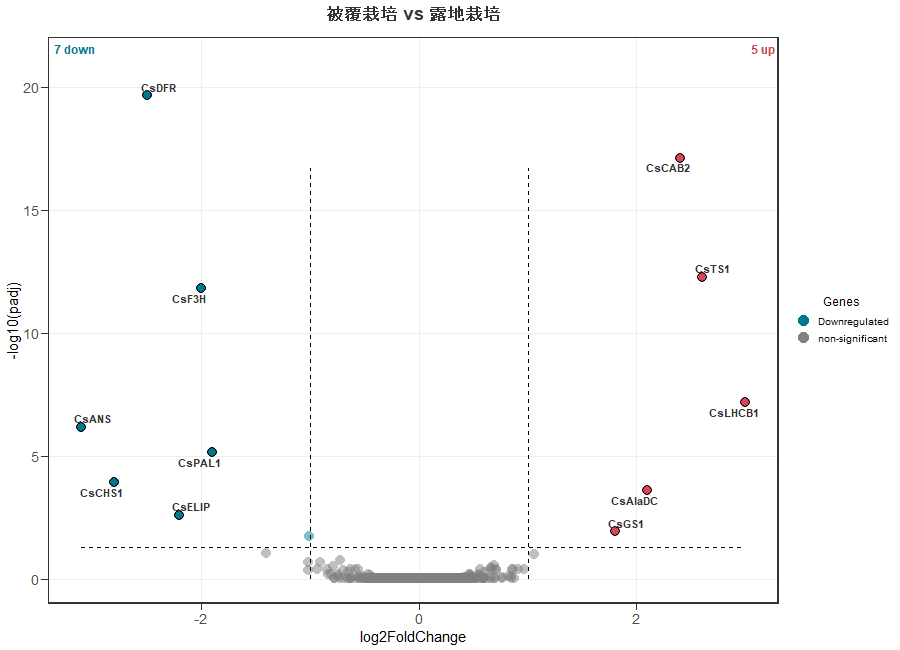
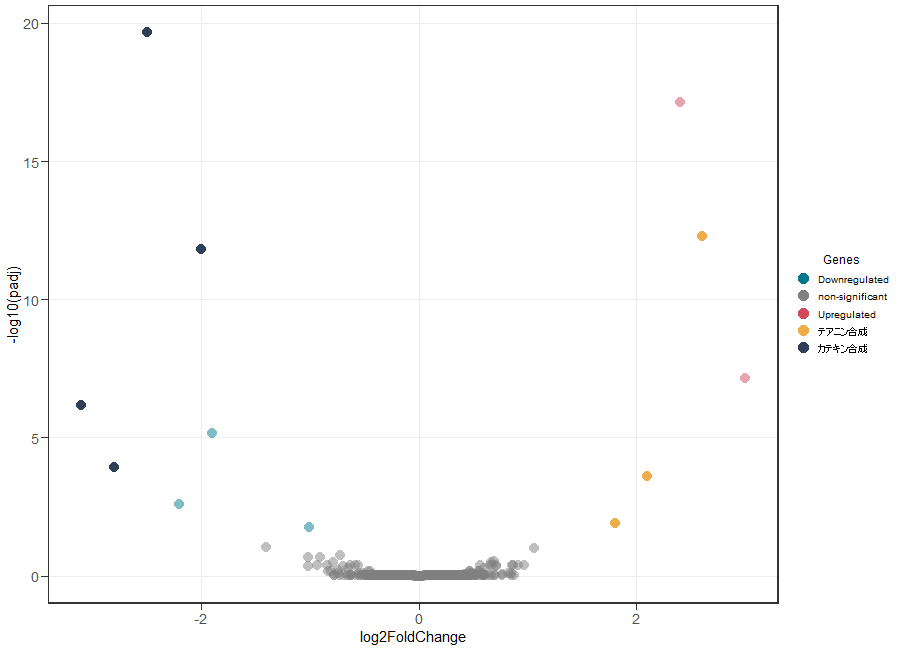
ボルケーノプロットは、横軸に2つの条件の発現量の比(log2倍率変化)、縦軸に有意性(p値の-log10)を取った散布図です。右上に行くほど大きく増え、左上に行くほど大きく減り、しかも差が確かな遺伝子になります。ここでは、宇治茶の茶葉を被覆栽培(覆い下)と露地栽培で比べた架空の解析結果を作ります。被覆するとうま味成分のテアニンが増え、渋み成分のカテキンが減ることを、遺伝子の増減として持たせています。
# 宇治茶の被覆栽培と露地栽培で茶葉の遺伝子発現を比べた架空の結果を作る
set.seed(2026)

# 増減を持たせる遺伝子(テアニン合成・光合成の遺伝子が増え、カテキン合成の遺伝子が減る)
named <- c(
  "CsTS1", "CsGS1", "CsAlaDC", "CsLHCB1", "CsCAB2", "CsELIP",
  "CsCHS1", "CsF3H", "CsDFR", "CsANS", "CsTCS1", "CsPAL1"
)
named_lfc <- c(
  2.6, 1.8, 2.1, 3.0, 2.4, -2.2,
  -2.8, -2.0, -2.5, -3.1, -1.4, -1.9
)

# 400遺伝子の差分発現解析の結果を作る。scaleで増減の大きさを変える
make_de <- function(scale) {
  n <- 400
  genes <- c(named, sprintf("Cs%04d", 1:(n - length(named))))
  lfc <- c(named_lfc * scale, rnorm(n - length(named), 0, 0.4))
  lfcSE <- runif(n, 0.25, 0.6)
  pvalue <- 2 * pnorm(-abs(lfc / lfcSE))
  data.frame(
    genes = genes,
    baseMean = round(10^runif(n, 1.5, 4), 1),
    log2FoldChange = round(lfc, 3),
    lfcSE = round(lfcSE, 3),
    pvalue = pvalue,
    padj = p.adjust(pvalue, method = "BH")
  )
}

# 被覆栽培 vs 露地栽培の結果
uji_tea <- make_de(1)
ボルケーノプロットを作成:ggvolcコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| data1 | プロットする差分発現解析の結果を指定。データフレーム、またはDESeq2(DESeqResults、DESeqDataSet)、edgeR(TopTags、DGELRT、DGEExact)、limma(MArrayLM)のオブジェクト。遺伝子名はgenes列か行名に置く。名前付きのリストを渡すと、比較ごとに共通の軸のパネルを並べる | なし |
| data2 | 強調して名前を付ける遺伝子を指定。データフレーム、差分発現解析のオブジェクト、または遺伝子名の文字ベクトル。data1がリストのときは全パネルで強調する | NULL |
| size_var | 点の大きさに使う変数を指定。”log2FoldChange”または”pvalue”。NULLでは大きさを固定 | NULL |
| p_value | 有意とするしきい値を指定 | 0.05 |
| fc | 増加・減少とする倍率変化のしきい値を指定 | 1 |
| sig_col | 有意性の判定と縦軸に使う列を指定。”padj”(調整済みp値)または”pvalue”(生のp値)。”padj”の列が無いときは生のp値を使う | c(“padj”, “pvalue”) |
| label_top | 整数。有意な遺伝子のうち、有意性の高い順にこの数だけ強調して名前を付ける。data2と併用できる | NULL |
| label_dir | label_topで選ぶ向きを指定。”both”(全体の上位)、”up”(増加の上位)、”down”(減少の上位)、”each”(増加と減少のそれぞれ上位) | c(“both”, “up”, “down”, “each”) |
| title | プロットのタイトルを指定 | NULL |
| interactive | 論理値。TRUEで点に重ねると遺伝子名と統計量が出るggiraphのウィジェットを返す。ggiraphパッケージが要る | FALSE |
| palette | 配色を指定。ggvolc_palettesにある名前、またはc(down = “navy”, up = “firebrick”)のような名前付きベクトル | “default” |
| not_sig_color | 有意でない遺伝子の色を指定。paletteより優先 | NULL |
| down_reg_color | 減少した遺伝子の色を指定。paletteより優先 | NULL |
| up_reg_color | 増加した遺伝子の色を指定。paletteより優先 | NULL |
| add_seg | 論理値。TRUEでp値と倍率変化のしきい値に破線を引く | FALSE |
| show_counts | 論理値。TRUEで有意に減少・増加した遺伝子の数を上の両隅に表示 | FALSE |
| highlight | 色分けする遺伝子のセットを名前付きのリストで指定。有意性に関わらずセットの色になり、凡例に載る。複数のセットに入る遺伝子は最初のセットの色 | NULL |
| highlight_colors | highlightのセットの色を、順番またはセット名付きで指定 | NULL |
| highlight_alpha | highlightの点の透明度を0(透明)から1(不透明)で指定。全体に1つ、またはセットごとに指定 | 0.5 |
| flip | 論理値。TRUEで縦軸をlog2倍率変化、横軸を有意性に入れ替える | FALSE |
| facet_scales | 複数の比較を並べるとき、パネルごとに変えてよい軸を指定。”fixed”、”free_y”、”free_x”、”free”。NULLでは有意性の軸だけをパネルごとに変える | NULL |
| coef | 係数が複数あるlimmaの結果で使う係数、またはDESeqDataSetで使う結果の名前を指定 | NULL |
# 増加・減少の上位6遺伝子ずつに名前を付け、しきい値の破線と遺伝子数を表示
ggvolc(uji_tea,
  label_top = 6, label_dir = "each",
  add_seg = TRUE, show_counts = TRUE,
  title = "被覆栽培 vs 露地栽培"
)

# テアニン合成とカテキン合成の遺伝子をセットごとに色分けしてプロット
ggvolc(uji_tea,
  highlight = list(
    テアニン合成 = c("CsTS1", "CsGS1", "CsAlaDC"),
    カテキン合成 = c("CsCHS1", "CsF3H", "CsDFR", "CsANS")
  ),
  highlight_alpha = 1
)

# 被覆7日目・14日目・21日目の比較を名前付きリストにまとめる
shade <- list(
  "被覆7日目" = make_de(0.5),
  "被覆14日目" = make_de(1),
  "被覆21日目" = make_de(1.4)
)

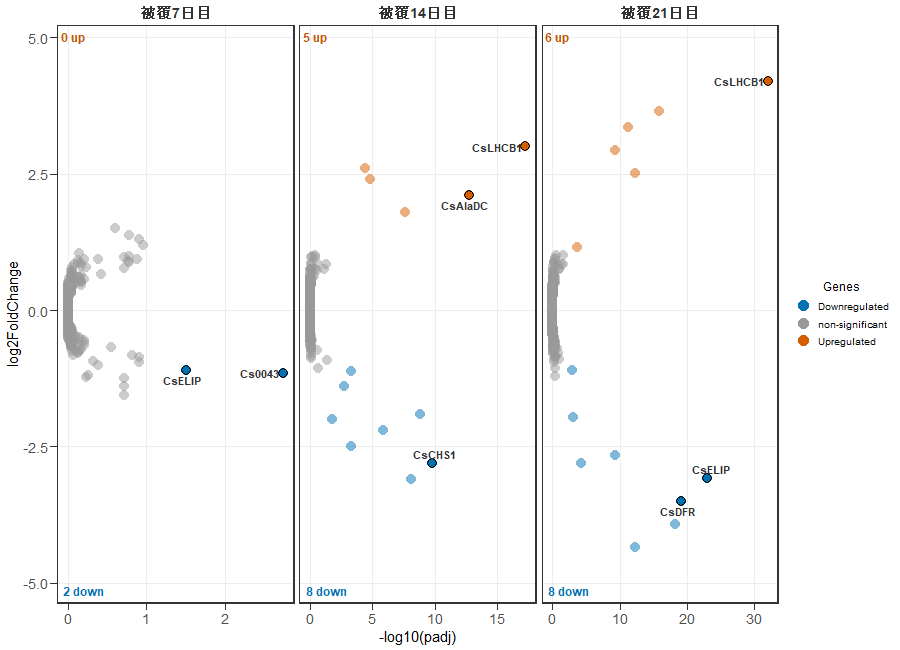
# 比較ごとのパネルを並べ、軸を入れ替えて倍率変化の軸をそろえてプロット
ggvolc(shade,
  label_top = 3, show_counts = TRUE,
  flip = TRUE, palette = "okabe_ito"
)

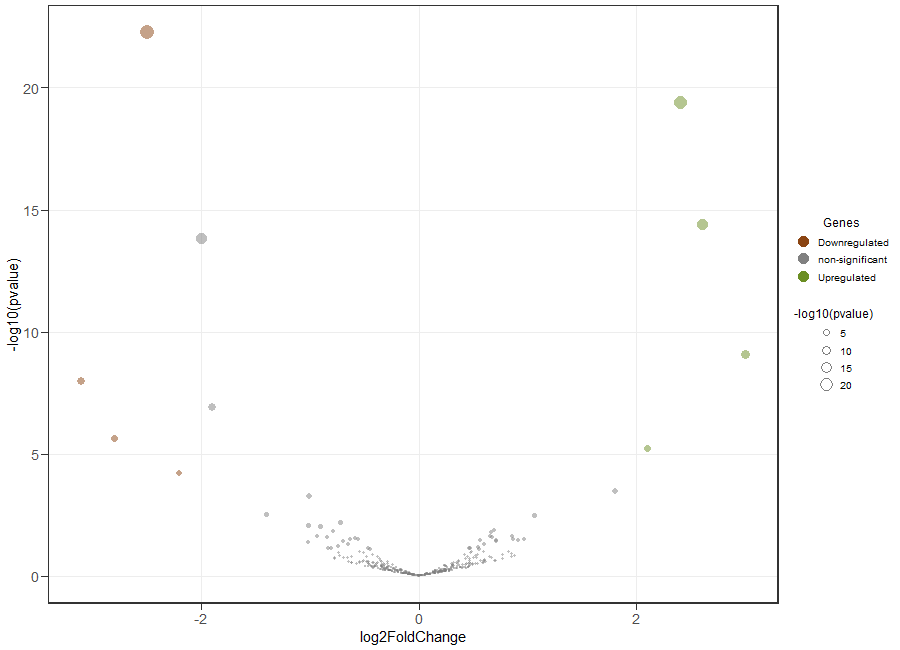
# 生のp値で判定し、しきい値を厳しくして、点の大きさをp値で変えてプロット
ggvolc(uji_tea,
  sig_col = "pvalue", p_value = 0.01, fc = 2,
  size_var = "pvalue",
  up_reg_color = "#6B8E23", down_reg_color = "#8B4513"
)
増加・減少の上位6遺伝子ずつに名前を付け、しきい値の破線と遺伝子数を表示
テアニン合成とカテキン合成の遺伝子をセットごとに色分けしてプロット
比較ごとのパネルを並べ、軸を入れ替えて倍率変化の軸をそろえてプロット
生のp値で判定し、しきい値を厳しくして、点の大きさをp値で変えてプロット
<おすすめのRに関する書籍です>
ボルケーノプロットに遺伝子の一覧表を添える:genes_tableコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| plot_obj | ggplotオブジェクトを指定。主にggvolcの結果 | なし |
| data2 | 表に載せる遺伝子の情報を指定。データフレーム、またはDESeq2・edgeR・limmaの結果オブジェクト。genes、log2FoldChange、pvalueの列が要り、baseMean、padjは任意。top_nを指定するときは解析結果の全体を渡してよい | なし |
| top_n | 整数。data2の有意な遺伝子から、有意性の高い順にこの数だけ表に載せる。NULLではdata2の全行を載せる | NULL |
| sig_col | top_nで順位付けに使う列を指定。”padj”または”pvalue” | c(“padj”, “pvalue”) |
| dir | top_nで選ぶ向きを指定。”both”、”up”、”down”、”each”(増加と減少のそれぞれ上位) | c(“both”, “up”, “down”, “each”) |
| p_value | p値の列の色分けと、top_nで選ぶ遺伝子の絞り込みに使うしきい値を指定 | 0.05 |
| table_height | 表の高さをプロット(3)に対する比で指定。NULLでは行数に合わせた高さ | NULL |
| palette | log2FC列の配色を指定。NULLではplot_objの配色を引き継ぐ | NULL |
| coef | data2が係数を複数持つlimmaの結果のとき、取り出す係数を指定 | NULL |
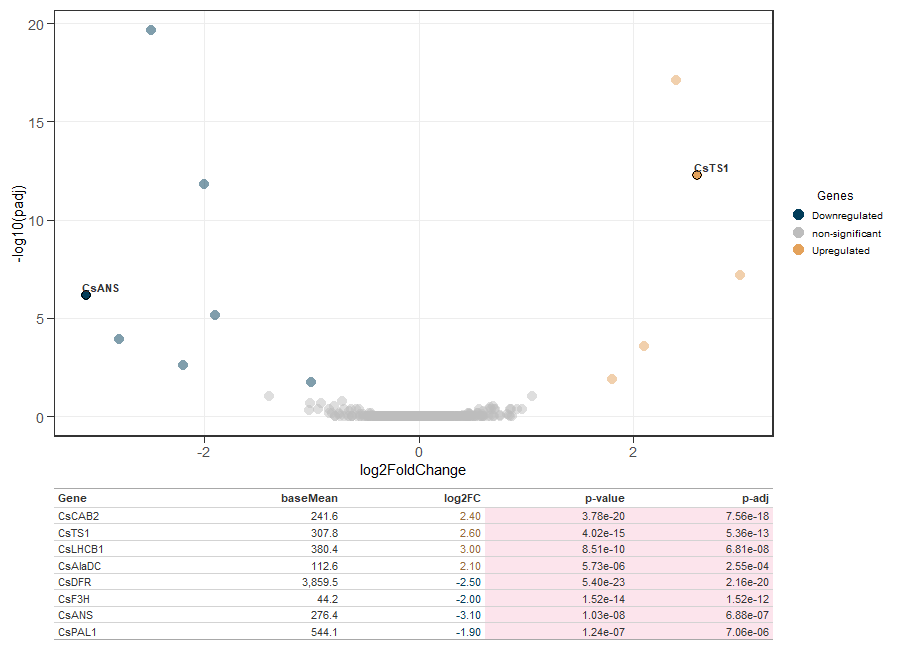
# 注目する2遺伝子に名前を付けたボルケーノプロットを作る
p <- ggvolc(uji_tea, c("CsTS1", "CsANS"), palette = "seafarer")

# 増加・減少の上位4遺伝子ずつを一覧表にしてプロットの下に添える
genes_table(p, uji_tea, top_n = 4, dir = "each")
増加・減少の上位4遺伝子ずつを一覧表にしてプロットの下に添える
解析結果をデータフレームにそろえる:de_tableコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| x | 差分発現解析の結果オブジェクト、またはデータフレームを指定 | なし |
| coef | 係数が複数あるlimmaの結果で取り出す係数(名前か番号)を指定。DESeqDataSetではDESeq2::resultsのnameに渡す。それ以外では使わない | NULL |
# ggvolcが読み取る列名にそろえたデータフレームを確認
head(de_table(uji_tea), 4)
    genes baseMean log2FoldChange lfcSE       pvalue         padj
1   CsTS1    307.8            2.6 0.331 4.019504e-15 5.359339e-13
2   CsGS1    507.7            1.8 0.502 3.346351e-04 1.216855e-02
3 CsAlaDC    112.6            2.1 0.463 5.729148e-06 2.546288e-04
4 CsLHCB1    380.4            3.0 0.489 8.513819e-10 6.811055e-08
使える配色の一覧を表示:ggvolc_palettesコマンド
オプションはありません。colorblind_safe列がTRUEの配色は、色覚の多様性に配慮したものです。
# 配色の名前と色の一覧を表示
ggvolc_palettes()
    palette    down not_sig      up colorblind_safe             source
1   default #00798c #808080 #d1495b           FALSE         ltc: minou
2 okabe_ito #0072B2 #999999 #D55E00            TRUE Okabe & Ito (2008)
3      rdbu #0571b0 #999999 #ca0020            TRUE   ColorBrewer RdBu
4 pantone23 #1F2C43 #B8B8B8 #FFB000            TRUE     ltc: pantone23
5  seafarer #013D5A #BDBDBD #E4A25B            TRUE      ltc: seafarer
6  midnight #075056 #B0B0B0 #FF5B04           FALSE      ltc: midnight
7      maya #3d5a80 #A9A9A9 #ee6c4d           FALSE          ltc: maya
8     trio1 #0E7175 #B0B0B0 #FD7901           FALSE         ltc: trio1

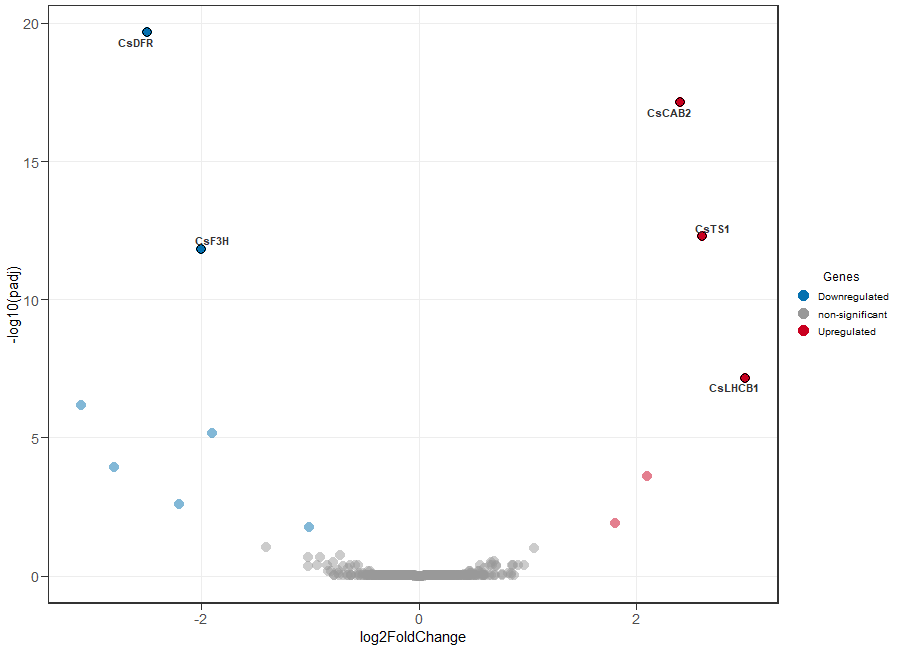
# 色覚の多様性に配慮した"rdbu"でプロット
ggvolc(uji_tea, label_top = 5, palette = "rdbu")
色覚の多様性に配慮した”rdbu”でプロット
<おすすめのRに関する書籍です>
この記事が誰かの役に立ちますように。