からだにいいもの
Rで解析:電子カルテの受診記録から受診ごとに疾患の有無を推定する「PheVis」パッケージ
「PheVis」パッケージは、電子カルテの受診記録から、患者がその受診の時点で対象の疾患にかかっているかを確率として推定できるパッケージです。渡すのは1行が1回の受診にあたるデータフレームで、患者ID・受診ID・受診日(数値)の列と、主となる病名コード(ICD)や医学用語(CUI)の出現回数、症状・検査・処方などの説明変数の列を持たせます。正解のラベルを人手で付けなくても学習でき、結果は受診ごとの確率と、患者ごとの経過の図で確かめられます。カルテレビューの対象を絞り込んだり、疾患にかかっていた時期を受診単位で追ったりするときに役立てることができるのではないかと考えます。
パッケージバージョンは1.0.5。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>
パッケージのインストール
下記コマンドを実行してください。
# パッケージのインストール
install.packages("PheVis")

# 評価で使うパッケージのインストール
install.packages("PRROC")

# パッケージの読み込み
library("PheVis")
Warning message:
package 'PheVis' was built under R version 4.6.2

library("PRROC")
Loading required package: rlangコマンド例
詳細はコメント、パッケージのヘルプを確認してください。
フェノタイピングは、診療記録から「どの患者が、いつ、ある疾患にかかっていたか」を判定する作業です。ICDは国際疾病分類の病名コード、CUIは医学用語を統一した識別子(UMLSの概念ID)で、カルテの文章から抽出した用語の出現回数として使われます。PheVisは、主となるICDとCUIの出現回数を、過去の受診から積み上げた代理指標にし、それを手がかりに説明変数全体から受診ごとの確率を推定します。
以降の例では、京都市内の診療所の受診記録を想定した架空のデータを共通して使用します。80人の1年分の受診で、約半数の患者は40日間だけ肺炎にかかります。正解の列(ill)は学習には使わず、評価のときだけ使います。
# 京都市内の診療所の受診記録を想定した架空データを作成
set.seed(1192)

# 患者数と居住区
n_pat <- 80
ku <- c("左京区", "右京区", "伏見区", "山科区", "北区")

# 患者ごとに受診記録を作成
visits <- lapply(1:n_pat, function(i) {
  # 受診回数と受診日(1月1日からの日数)
  n_vis <- sample(8:20, 1)
  day <- sort(sample(1:365, n_vis))
  # 約半数の患者は発症日から40日間だけ肺炎にかかる
  onset <- sample(30:300, 1)
  ill <- as.integer(runif(1) < 0.5 & day >= onset & day < onset + 40)
  # 病名コード・医学用語・症状・検査・処方の出現回数は罹患中の受診で多くなる
  data.frame(
    patient = i, ku = sample(ku, 1), day = day, ill = ill,
    icd_main = rpois(n_vis, 0.2 + 2.0 * ill),
    cui_main = rpois(n_vis, 1 + 6 * ill),
    fever = rpois(n_vis, 0.5 + 2 * ill),
    cough = rpois(n_vis, 0.8 + 1.5 * ill),
    crp = rpois(n_vis, 1 + 3 * ill),
    xray = rpois(n_vis, 0.3 + 1 * ill),
    antibiotic = rpois(n_vis, 0.2 + 1.5 * ill)
  )
})

# 1行1受診のデータフレームにまとめ、受診IDを付ける
kyoto_visit <- do.call(rbind, visits)
kyoto_visit$visit_id <- seq_len(nrow(kyoto_visit))

# 先頭の受診を確認
head(kyoto_visit[, c("patient", "visit_id", "ku", "day", "ill", "icd_main", "cui_main", "fever")])
  patient visit_id   ku day ill icd_main cui_main fever
1       1        1 北区  17   0        0        0     1
2       1        2 北区  37   0        0        1     0
3       1        3 北区  59   0        1        1     0
4       1        4 北区  67   0        0        1     0
5       1        5 北区 121   0        0        0     0
6       1        6 北区 131   0        0        1     1

# 患者単位で学習用60人とテスト用20人に分ける
train_pat <- sample(unique(kyoto_visit$patient), 60)
df_train <- kyoto_visit[kyoto_visit$patient %in% train_pat, ]
df_test <- kyoto_visit[!kyoto_visit$patient %in% train_pat, ]

# 説明変数(主となるICDとCUIも含める)
var_vec <- c("icd_main", "cui_main", "fever", "cough", "crp", "xray", "antibiotic")
<おすすめのRに関する書籍です>

 www.amazon.co.jp
受診記録から予測モデルを学習:train_phevisコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| half_life | 出現回数を積み上げる期間。慢性疾患ならInf、急性疾患なら疾患の持続期間を指定 | なし |
| df | すべての変数を含むデータフレーム | なし |
| START_DATE | 受診日の列名。列は数値である必要があります | なし |
| PATIENT_NUM | 患者IDの列名 | なし |
| ENCOUNTER_NUM | 受診IDの列名 | なし |
| var_vec | 予測に使う説明変数の列名。主となる変数も含める | なし |
| main_icd | 主となるICDコードの列名の文字ベクトル | なし |
| main_cui | 主となるCUIの列名の文字ベクトル | なし |
| rf | ランダムフォレストによる疑似ラベル付けを使うか | TRUE |
| p.noise | ノイズ付与の段階で加えるノイズの割合 | 0.3 |
| bool_SAFE | TRUEでSAFEによる変数選択を行う | TRUE |
| omega | 両端の集団(確実に罹患/非罹患とみなす集団)を決める定数 | 2 |
| GS | 正解の変数名の文字列。NULLのときは0のベクトルを使う | NULL |
# 急性疾患を想定し、出現回数を積み上げる期間を30日にして学習
fit <- train_phevis(
  half_life = 30,
  df = df_train,
  START_DATE = "day",
  PATIENT_NUM = "patient",
  ENCOUNTER_NUM = "visit_id",
  var_vec = var_vec,
  main_icd = "icd_main",
  main_cui = "cui_main"
)
-- Arguments passed check -> PheVis begins --
Joining with `by = join_by(id, id_encounter, var, start_date)`Joining with `by = join_by(PATIENT_NUM, ENCOUNTER_NUM)`Joining with `by = join_by(START_DATE, PATIENT_NUM, ENCOUNTER_NUM)`

# 学習結果に含まれる要素を確認
names(fit)
[1] "surparam"        "model"           "df_train_result" "train_param"
[5] "df_x_train"
<おすすめのRに関する書籍です>
新しい受診記録で確率を予測:test_phevisコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| train_param | 学習に使った設定(変数、主となるICDとCUI、half_life、正解、omega)。通常はtrain_phevisコマンドの結果から取る | なし |
| df_test | 予測を行うデータフレーム | なし |
| surparam | 代理指標の計算に使う設定。通常はtrain_phevisコマンドの結果から取る | なし |
| model | ランダム切片ロジスティック回帰のモデル。通常はtrain_phevisコマンドの結果から取る | なし |
| START_DATE | 受診日の列名。列は数値である必要があります | なし |
| PATIENT_NUM | 患者IDの列名 | なし |
| ENCOUNTER_NUM | 受診IDの列名 | なし |
# テスト用20人の受診ごとに罹患の確率を予測
res <- test_phevis(
  train_param = fit$train_param,
  df_test = df_test,
  surparam = fit$surparam,
  model = fit$model,
  START_DATE = "day",
  PATIENT_NUM = "patient",
  ENCOUNTER_NUM = "visit_id"
)
-- Arguments passed check -> PheVis begins --
Joining with `by = join_by(id, id_encounter, var, start_date)`Joining with `by = join_by(PATIENT_NUM, ENCOUNTER_NUM)`Joining with `by = join_by(START_DATE, PATIENT_NUM, ENCOUNTER_NUM)`

# 予測結果に含まれる要素を確認
names(res)
[1] "df_result" "df_pred"

# 受診IDで正解の列と突き合わせる
eval_df <- merge(res$df_result, df_test[, c("visit_id", "ill")],
  by.x = "ENCOUNTER_NUM", by.y = "visit_id"
)
head(eval_df[, c("PATIENT_NUM", "START_DATE", "PREDICTION", "ill")])
  PATIENT_NUM START_DATE   PREDICTION ill
1           1         17 3.855136e-06   0
2           1         37 9.663427e-05   0
3           1         59 4.385256e-02   0
4           1         67 1.371831e-01   0
5           1        121 3.241059e-05   0
6           1        131 1.459114e-03   0

# ROC曲線の下の面積
roc.curve(scores.class0 = eval_df$PREDICTION, weights.class0 = eval_df$ill)$auc
[1] 0.9854086

# PR曲線の下の面積
pr.curve(scores.class0 = eval_df$PREDICTION, weights.class0 = eval_df$ill)$auc.integral
[1] 0.7799989

患者ごとの予測の経過をプロット:ggindividual_plotコマンド
| オプション | 意味 | 初期値 |
|---|---|---|
| subject | 患者IDの数値ベクトル | なし |
| time | 受診日(時間または日付)の数値ベクトル | なし |
| gold_standard | 正解の数値ベクトル | なし |
| prediction | 予測値の数値ベクトル | なし |
# 肺炎にかかったテスト用の患者を1人選び、受診日順に並べる
ill_pat <- unique(eval_df$PATIENT_NUM[eval_df$ill == 1])[1]
one <- eval_df[eval_df$PATIENT_NUM == ill_pat, ]
one <- one[order(one$START_DATE), ]

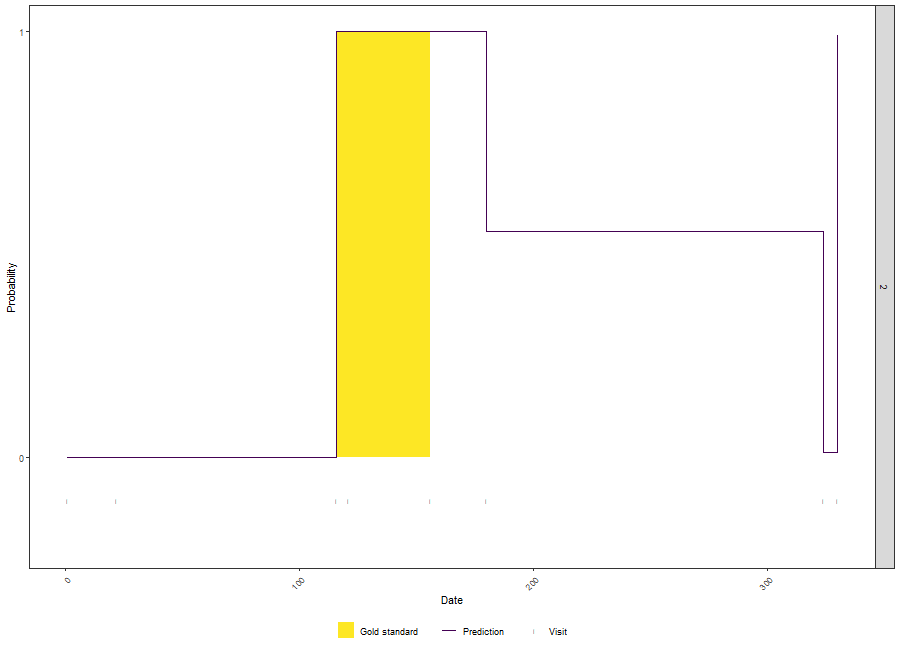
# 受診ごとの予測確率と、実際に罹患していた期間をプロット
ggindividual_plot(
  subject = one$PATIENT_NUM,
  time = one$START_DATE,
  gold_standard = one$ill,
  prediction = as.numeric(one$PREDICTION)
)
受診ごとの予測確率と、実際に罹患していた期間をプロット
この記事が誰かの役に立ちますように。