からだにいいもの
Rで解析:反復測定や多層データの曲線的な変化をスプラインで当てはめる「MultiSpline」パッケージ
「MultiSpline」パッケージは、反復測定や、学校と生徒のような入れ子の構造を持つデータで、結果が説明変数に対して曲線を描いて変わる様子を、スプラインで当てはめて調べられるパッケージです。渡すのは、1行が1回の測定にあたる縦長のデータフレームで、結果の列、曲線で表したい数値の列、個体や集団を表す列の名前を文字列で指定します。モデルの当てはめには内部でlme4パッケージとmgcvパッケージを使い、結果の図はggplot2パッケージで返ります。ノット数の選択から、予測値、傾きの変化、集団ごとの曲線のばらつきまでを同じモデルから順に取り出せます。成長や経過の曲線を、個体差を考えたうえで読みたいときに役立てられるのではないかと考えます。
パッケージバージョンは0.3.0。Windows 11 x64 (build 26200)のR version 4.6.1で確認しています。
<おすすめのRに関する書籍です>

パッケージのインストール
下記コマンドを実行してください。lmerTestパッケージは係数のp値の計算に、patchworkパッケージは複数の図を並べるときに使います。
# パッケージのインストール
install.packages(c("MultiSpline", "lmerTest", "patchwork"))

# パッケージの読み込み
library("MultiSpline")コマンド例
詳細はコメント、パッケージのヘルプを確認してください。
スプライン:区間ごとの多項式をなめらかにつないで曲線を表す方法。ノット(つなぎ目)の数は自由度(df)で決まり、多いほど細かく曲がる。クラスター:同じ個体や集団からの測定のまとまり。混合モデルではクラスターごとの違いを変量効果として扱う。
例として、宇治、宇治田原、和束、南山城の茶園24か所で、施肥後0〜12週の新芽の長さを毎週測った架空のデータを作ります。新芽は5週目前後で急に伸び、その後は頭打ちになるとし、伸び始めの長さと伸びの大きさは茶園ごとに変えています。
# 宇治茶の茶園24か所で、施肥後0〜12週の新芽の長さ(cm)を測った架空データを作成
set.seed(1205)
Garden <- paste0(
  rep(c("Uji", "Ujitawara", "Wazuka", "Minamiyamashiro"), each = 6),
  "_", rep(1:6, times = 4)
)
UjiTea <- expand.grid(Week = 0:12, Garden = Garden, stringsAsFactors = FALSE)
UjiTea$Area <- sub("_.*", "", UjiTea$Garden)

# 茶園ごとの伸び始めの長さと伸びの大きさ
Base <- setNames(rnorm(24, mean = 0, sd = 1.2), Garden)
Gain <- setNames(rnorm(24, mean = 1, sd = 0.15), Garden)

# 5週目前後で急に伸び、その後は頭打ちになるS字の伸び方
UjiTea$Shoot <- round(2 + Base[UjiTea$Garden] +
  Gain[UjiTea$Garden] * 9 / (1 + exp(-(UjiTea$Week - 5) / 1.5)) +
  rnorm(nrow(UjiTea), mean = 0, sd = 0.6), 1)

# データの確認
head(UjiTea)
  Week Garden Area Shoot
1    0  Uji_1  Uji   3.0
2    1  Uji_1  Uji   2.4
3    2  Uji_1  Uji   3.1
4    3  Uji_1  Uji   4.2
5    4  Uji_1  Uji   5.7
6    5  Uji_1  Uji   7.0
スプラインの自由度を情報量規準で選ぶ:nl_knotsコマンド
df_rangeオプションに並べた自由度で順にモデルを当てはめ、AICまたはBICが最も小さい自由度を示します。plot = TRUE では、自由度ごとの情報量規準の図も出ます。比較には最尤法を使います。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | データフレーム | なし |
| y | 結果の変数名(文字列) | なし |
| x | 曲線で表す説明変数の名前(文字列) | なし |
| time | 時点の変数名 | NULL |
| cluster | クラスターの変数名の文字列ベクトル | NULL |
| nested | TRUEでクラスターを入れ子として扱う | FALSE |
| controls | 統制する変数名の文字列ベクトル | NULL |
| random | 変量効果の部分をまとめて書いた文字列。nl_fitと同じ | NULL |
| method | スプラインの種類。”ns”:自然3次スプライン、”bs”:Bスプライン | c(“ns”, “bs”) |
| df_range | 候補にする自由度の整数ベクトル | 2:10 |
| criterion | 選ぶときの情報量規準。”AIC” または “BIC” | c(“AIC”, “BIC”) |
| family | 分布族のオブジェクト | stats::gaussian() |
| plot | TRUEで、自由度ごとの情報量規準の図を出す | TRUE |
| … | モデルを当てはめるコマンドに渡すオプション | なし |
# 茶園をクラスターとして、自由度2〜6からAICで選ぶ
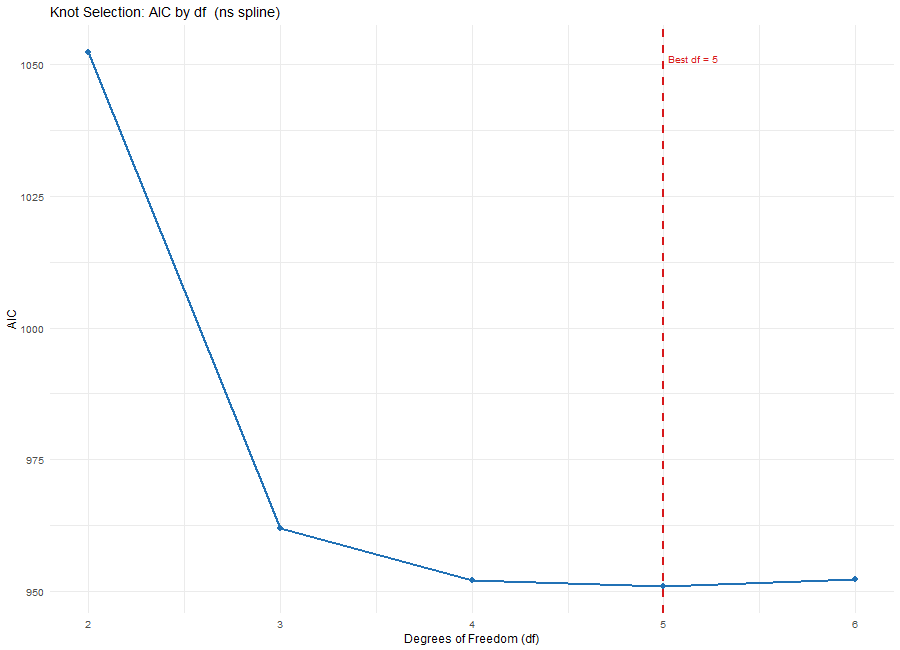
nl_knots(UjiTea, y = "Shoot", x = "Week", cluster = "Garden", df_range = 2:6)
Best df = 5  (AIC = 950.83)
茶園をクラスターとして、自由度2〜6からAICで選ぶ
スプラインを組み込んだモデルを当てはめる:nl_fitコマンド
xオプションの変数をスプラインに展開してモデルを当てはめます。clusterオプションを指定すると、lme4パッケージの混合モデル(正規分布ならlmer、ほかの分布族ならglmer)になります。randomオプションに lme4 の書き方で変量効果を書くと、cluster、nested、random_slope より優先されます。method = “gam” は単一レベルのモデルだけで使えます。nl_knotsでは自由度5が選ばれましたが、自由度4とのAICの差は1.3ほどなので、ここでは自由度4のモデルを当てはめ、以降の節で使い回します。
| オプション | 意味 | 初期値 |
|---|---|---|
| data | データフレーム。縦断データでは縦長の形 | なし |
| y | 結果の変数名(文字列) | なし |
| x | 曲線で表す説明変数の名前(文字列)。数値の列であること | なし |
| time | 時点の変数名(文字列) | NULL |
| cluster | 変量効果にするグループの変数名。NULL、”id”、2方向のクラスターなら c(“id”, “school”) のように指定 | NULL |
| nested | clusterが2つのときだけ使う。TRUEで1つ目を2つ目の中に入れ子にする(cluster = c(“student”, “school”) なら (1 | school/student))。FALSEは交差分類の (1 | g1) + (1 | g2)。より複雑な構造はrandomで指定 | FALSE |
| controls | 固定効果に加える項の文字列ベクトル。c(“age”, “factor(race)”, “I(age^2)”) のように変数名も式も使える。因子と文字列の変数は自動でダミー変数になる | NULL |
| random | lme4の式の変量効果の部分を書いた文字列。”(1 | school/student)”、”(1 | idcode) + (1 | indcode)” など。指定するとcluster、nested、random_slopeより優先される | NULL |
| method | スプラインの種類。”ns”:自然3次スプライン、”bs”:Bスプライン、”gam”:mgcv::gam()による平滑化。多層モデルでは “ns” か “bs” | c(“ns”, “bs”, “gam”) |
| df | スプラインの自由度。1以上の整数、または “auto” で情報量規準による自動選択 | 4 |
| df_range | df = “auto” のときに候補にする自由度の整数ベクトル | 2:8 |
| df_criterion | 自由度の自動選択に使う情報量規準。”AIC” または “BIC” | c(“AIC”, “BIC”) |
| k | method = “gam” のときのmgcv::s()の基底の次元 | 5 |
| bs_degree | method = “bs” のときのsplines::bs()の次数。3は3次 | 3 |
| random_slope | TRUEで、clusterを指定したときに変量切片に加えてスプラインの変量傾きも入れる。今のところクラスターが1つのときだけ | FALSE |
| family | stats::gaussian()、stats::binomial() などの分布族のオブジェクト。多層モデルでは、gaussian()はlme4::lmer()、ほかはlme4::glmer()で当てはめる | stats::gaussian() |
| REML | 正規分布の混合モデルで、最終のモデルを制限付き最尤法で当てはめる。自由度の自動選択とモデルの比較では常に最尤法を使う | TRUE |
| … | モデルを当てはめるコマンド(stats::lm()、mgcv::gam()、lme4::lmer()、lme4::glmer())に渡すオプション | なし |
# 茶園ごとの変量切片を入れた、自由度4の自然3次スプラインのモデル
fit <- nl_fit(UjiTea, y = "Shoot", x = "Week", cluster = "Garden", df = 4)
係数の表を出す:nl_summaryコマンド
固定効果の係数、標準誤差、自由度、検定統計量、p値を表で返します。スプラインの係数は1つずつでは解釈しにくいので、曲線の形は後の節の予測値と傾きで読みます。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | nl_fitの結果 | なし |
| digits | 丸める小数点以下の桁数。NULLで丸めない | 3 |
| pvals | TRUEでp値を付ける | TRUE |
| df_method | lmerのモデルでp値を付けるときの自由度の求め方。”satterthwaite”(lmerTestパッケージが必要)または “none” | c(“satterthwaite”, “none”) |
# 係数の表を表示
nl_summary(fit)
# A tibble: 5 × 6
  Term                       Estimate Std.Error    df statistic p.value
  <chr>                         <dbl>     <dbl> <dbl>     <dbl>   <dbl>
1 (Intercept)                    1.86     0.41   31.7      4.54 0.00008
2 splines::ns(Week, df = 4)1     5.96     0.257 284       23.2  0
3 splines::ns(Week, df = 4)2     7.83     0.241 284       32.6  0
4 splines::ns(Week, df = 4)3     8.5      0.443 284       19.2  0
5 splines::ns(Week, df = 4)4     8.09     0.211 284       38.3  0
スプラインの項をまとめて検定する:nl_waldコマンド
スプラインに展開した項のすべての係数が0かどうかを、Wald検定でまとめて調べます。説明変数が結果に関係しているかを1つのp値で確かめられます。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | method = “ns” または “bs” で当てはめたnl_fitの結果 | なし |
# 施肥後の週の項をまとめて検定
nl_wald(fit)
  term    chisq df p.value
1 Week 3547.585  4       0
<おすすめのRに関する書籍です>
級内相関係数を求める:nl_iccコマンド
変量効果の分散が、全体の分散(固定効果の分を除く)のうちどれだけを占めるかを、クラスターごとに返します。この例では、新芽の長さのばらつきのおよそ8割が茶園の違いによるものです。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | clusterを指定して当てはめたnl_fitの結果(lme4::lmer()またはlme4::glmer()による多層モデル) | なし |
| include_residual | TRUEで残差の割合も出し、合計が1になるようにする | TRUE |
# 茶園と残差の割合
nl_icc(fit)
   Garden  Residual
0.7901774 0.2098226
決定係数と分散の内訳を出す:nl_r2コマンド
固定効果だけで説明できる割合(周辺R2)と、変量効果まで含めた割合(条件付きR2)を出し、全体の分散を固定効果、クラスター、残差に分けて示します。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | nl_fitの結果 | なし |
| digits | 表示する小数点以下の桁数 | 4L |
# 決定係数と分散の内訳
nl_r2(fit)

=== MultiSpline R-squared Decomposition ===
Model type: LMM

  Marginal  R2m = 0.7053   (fixed effects only)
  Conditional R2c = 0.9382  (fixed + all random effects)

Variance Partition (r2_mlm-style):
     Component Variance Proportion
 Fixed effects  10.1605     0.7053
        Garden   3.3544     0.2329
      Residual   0.8907     0.0618
クラスターごとの曲線のばらつきを調べる:nl_hetコマンド
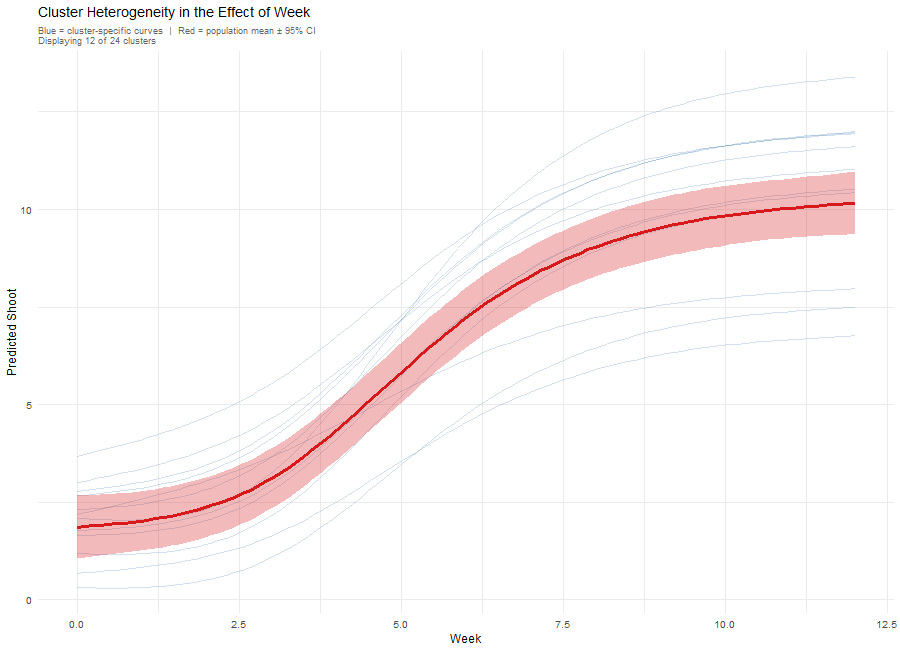
変量切片だけのモデルを、スプラインの変量傾きを入れたモデルに当てはめ直し、尤度比検定で比べます。曲線の形そのものがクラスターごとに違うかを調べられます。plot = TRUE では、クラスターごとの曲線と全体の平均の曲線を重ねた図が出ます。分散が0の境界で検定するため、p値は保守的です。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | クラスターを1つ指定して当てはめたnl_fitの結果。random_slope = FALSE のときは内部で当てはめ直す | なし |
| n_clusters_plot | 図に出すクラスターの曲線の最大数。Infですべて | 30L |
| x_seq | 予測に使うxの値の数値ベクトル | NULL |
| level | 全体の平均の曲線に付ける信頼区間の水準 | 0.95 |
| plot | TRUEで図を出す | TRUE |
| seed | 図に出すクラスターを選ぶときの乱数の種 | 42L |
# 茶園ごとの伸び方の違いを検定し、12園の曲線をプロット
het <- nl_het(fit, n_clusters_plot = 12)
Refitting with random spline slopes to assess heterogeneity ...
boundary (singular) fit: see help('isSingular')

--- LRT (ML): random spline slopes vs random intercepts ---
            model npar      AIC    logLik    Chisq Df     p.value
 random intercept    7 952.1294 -469.0647       NA NA          NA
    random slopes   21 768.9839 -363.4920 211.1455 14 2.88049e-37
p-value is conservative: variances are tested on the boundary.
茶園ごとの伸び方の違いを検定し、12園の曲線をプロット
直線や多項式のモデルと比べる:nl_compareコマンド
同じデータで直線と多項式のモデルを当てはめ、スプラインのモデルとAIC、BIC、対数尤度で比べます。直線のモデルとの尤度比検定も付きます。曲線で表す必要があるかを確かめるときに使います。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | 比べる元になるスプラインのモデル(nl_fitの結果) | なし |
| polynomial_degrees | 比べる多項式の次数の整数ベクトル。integer(0)で多項式を比べない | c(2L, 3L) |
| digits | 表の小数点以下の桁数 | 3L |
| return_models | TRUEで、比べたモデルのオブジェクトも返す | FALSE |
# 直線、2次、3次の多項式と比較
nl_compare(fit, polynomial_degrees = 2:3)

=== MultiSpline Model Comparison ===

   Model      AIC      BIC   LogLik npar Deviance LRT_vs_linear  LRT_p
  Linear 1085.408 1100.380 -538.704    4 1077.408            NA   <NA>
 Poly(2) 1055.292 1074.007 -522.646    5 1045.292        32.117 <0.001
 Poly(3)  974.230  996.688 -481.115    6  962.230       115.178 <0.001
  Spline  952.129  978.330 -469.065    7  938.129       139.279 <0.001

  Best model by AIC: Spline
<おすすめのRに関する書籍です>
当てはめた曲線の予測値を求める:nl_predictコマンド
xの値ごとに、当てはめた曲線の予測値と標準誤差、信頼区間を返します。type = “conditional” は変量効果を0とした典型的なクラスターの曲線、”marginal” は母集団で平均した曲線です。x_seqを指定しないときは、xの範囲を細かく区切った値で求めます。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | nl_fitの結果 | なし |
| x_seq | 予測に使うxの値の数値ベクトル | NULL |
| time_levels | 予測に使う時点の値のベクトル | NULL |
| controls_fixed | 統制する変数を固定する値の名前付きリスト | NULL |
| se | TRUEで標準誤差と信頼区間を付ける | TRUE |
| level | 信頼区間の水準 | 0.95 |
| type | “conditional”:変量効果を0とした曲線、”marginal”:母集団で平均した曲線 | c(“conditional”, “marginal”) |
| scale | “response”:結果の尺度、”link”:リンク関数の尺度 | c(“response”, “link”) |
| re_form | 互換のために残しているオプション。NA(変量効果を0にする)だけが使える。クラスターごとの曲線はnl_hetで求める | NA |
| glmer_ci | 正規分布以外の混合モデルでの信頼区間の求め方。”delta”:デルタ法、”boot”:lme4::bootMer()によるパラメトリックブートストラップ | c(“delta”, “boot”) |
| n_boot | glmer_ci = “boot” のときのブートストラップの回数 | 500L |
| … | 今後のために予約されたオプション | なし |
# 2週ごとの予測値と95%信頼区間
pred <- nl_predict(fit, x_seq = seq(0, 12, by = 2))
pred
# A tibble: 7 × 5
   Week   fit se.fit   lwr   upr
  <dbl> <dbl>  <dbl> <dbl> <dbl>
1     0  1.86  0.410  1.06  2.66
2     2  2.37  0.389  1.61  3.13
3     4  4.33  0.387  3.58  5.09
4     6  7.22  0.393  6.45  7.99
5     8  9.04  0.387  8.28  9.80
6    10  9.84  0.389  9.08 10.6
7    12 10.2   0.410  9.36 11.0
曲線の傾きと曲がり方を求める:nl_derivativesコマンド
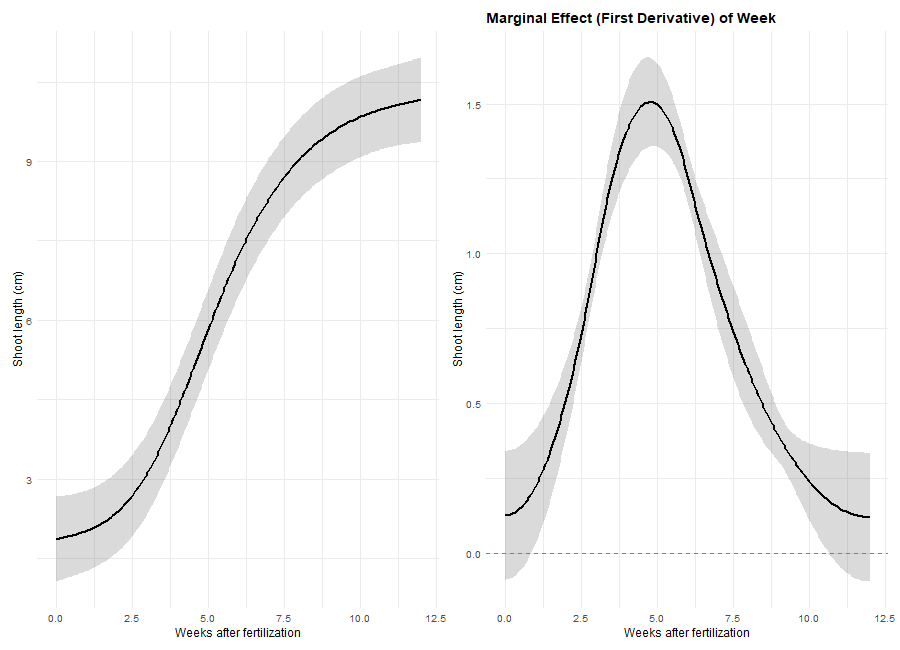
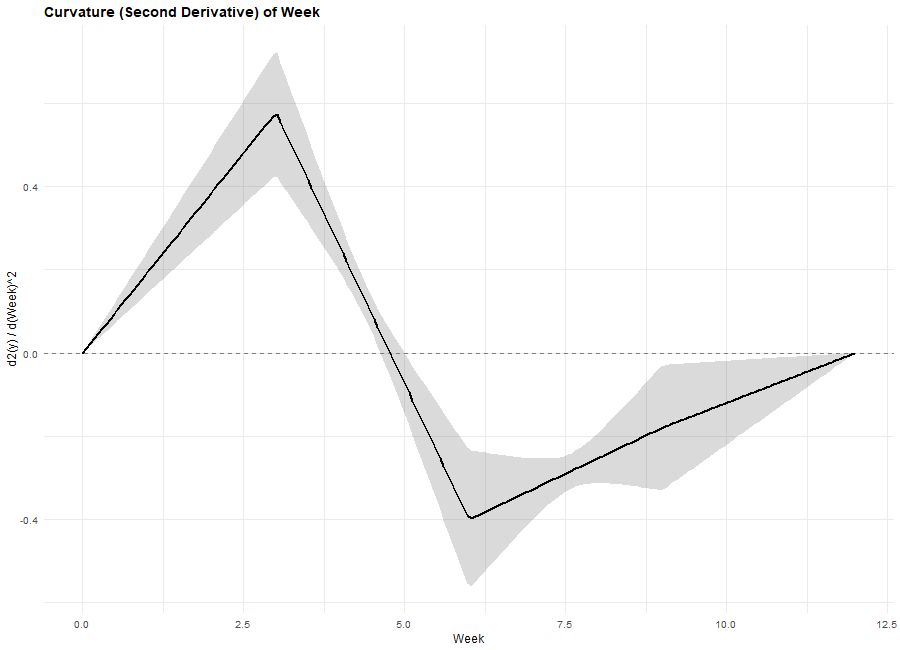
当てはめた曲線の一次微分(傾き、d1)と二次微分(曲がり方、d2)を、信頼区間付きで返します。この例では、新芽が最も速く伸びるのは5週目で、1週あたり約1.5cmです。0週目と11週目以降は、傾きの信頼区間が0をまたいでいます。
| オプション | 意味 | 初期値 |
|---|---|---|
| object | nl_fitの結果。0.2.0版のようにnl_predictの結果を渡すと、警告を出して信頼区間なしの値を返す | なし |
| x_seq | 求めるxの値。nl_predictと同じ | NULL |
| time_levels | 求める時点の値。nl_predictと同じ | NULL |
| controls_fixed | 統制する変数を固定する値。nl_predictと同じ | NULL |
| level | 信頼区間の水準 | 0.95 |
| type | nl_predictと同じ。”conditional” または “marginal” の曲線の微分を求める | c(“conditional”, “marginal”) |
| scale | nl_predictと同じ。”response” または “link” の尺度で微分を求める | c(“response”, “link”) |
| h | 中心差分の刻み幅。NULLはxの範囲の10^-4倍。基底を正確に計算するので、結果はhにほとんど左右されない | NULL |
| … | 無視される。0.2.0版のオプションを受け流すためのもの | なし |
# 1週ごとの傾きと信頼区間
deriv <- nl_derivatives(fit, x_seq = 0:12)
deriv[, c("Week", "d1", "d1_lwr", "d1_upr")]
# A tibble: 13 × 4
    Week    d1  d1_lwr d1_upr
   <dbl> <dbl>   <dbl>  <dbl>
 1     0 0.126 -0.0890  0.341
 2     1 0.223  0.0305  0.415
 3     2 0.512  0.384   0.639
 4     3 0.994  0.910   1.08
 5     4 1.41   1.26    1.55
 6     5 1.50   1.36    1.64
 7     6 1.26   1.18    1.35
 8     7 0.896  0.757   1.04
 9     8 0.606  0.461   0.751
10     9 0.390  0.306   0.474
11    10 0.240  0.112   0.367
12    11 0.150 -0.0422  0.342
13    12 0.120 -0.0952  0.335
極大・極小と変曲点の位置を探す:nl_turning_pointsコマンド
nl_derivativesの結果から、傾きが0になる点(極大・極小)、曲がる向きが変わる区間(変曲点)、増加・減少が続く区間を探します。この例は単調に伸び続けるS字なので極大・極小は無く、4〜5週目に下に凸から上に凸へ変わる区間が見つかります。
| オプション | 意味 | 初期値 |
|---|---|---|
| deriv_df | nl_derivativesの結果のデータフレーム | なし |
| x | 説明変数の列名(文字列)。既定ではnl_derivativesの結果から取る | attr(deriv_df, “x”) |
| time | 時点の列名(文字列)。指定すると時点ごとに探す | attr(deriv_df, “time”) |
| tol | 傾きを0とみなす許容誤差 | 1e-06 |
# 極大・極小、変曲点、増減の区間
nl_turning_points(deriv)
$turning_points
[1] Week fit  type
<0 rows> (or 0-length row.names)

$inflection_regions
  x_start x_end         direction
1       4     5 convex_to_concave

$slope_regions
  x_start x_end  direction
1       0    12 increasing
予測値の曲線と傾きをプロット:nl_plotコマンド
nl_predictとnl_derivativesの結果を、ggplot2パッケージのプロットにします。type = “trajectory” は予測値の曲線、”slope” は傾き、”curvature” は曲がり方、”combo” は予測値と傾きを横に並べた図です。
| オプション | 意味 | 初期値 |
|---|---|---|
| pred_df | nl_predictの結果のデータフレーム(type = “trajectory” と “combo” で使う) | NULL |
| deriv_df | nl_derivativesの結果のデータフレーム(type = “slope”、”curvature”、”combo” で使う) | NULL |
| x | 説明変数の列名(文字列)。既定ではnl_predict、nl_derivativesの結果から取る | NULL |
| time | 時点の列名(文字列)。NULLは自動で見つける | NULL |
| type | 図の種類。”trajectory”、”slope”、”curvature”、”combo” | c(“trajectory”, “slope”, “curvature”, “combo”) |
| show_ci | TRUEで信頼区間の帯を付ける | TRUE |
| ci_level | se.fitから信頼区間を作るときの水準 | 0.95 |
| show_turning_points | TRUEで、予測値の曲線に極大・極小の印を重ねる | FALSE |
| turning_points | nl_turning_pointsの結果のデータフレーム(show_turning_points = TRUE のときだけ使う) | NULL |
| zero_line | TRUEで、傾きと曲がり方の図の0の位置に点線を引く | TRUE |
| y_lab | Y軸のラベル | NULL |
| x_lab | X軸のラベル。既定はxの列名 | NULL |
| title | 図のタイトル | NULL |
| legend_title | 凡例のタイトル | NULL |
# 細かく区切った週で予測値と傾きを求める
pred_all <- nl_predict(fit)
deriv_all <- nl_derivatives(fit)

# 予測値の曲線と傾きを並べてプロット
nl_plot(pred_all, deriv_all,
  type = "combo",
  x_lab = "Weeks after fertilization", y_lab = "Shoot length (cm)"
)

# 曲がり方(二次微分)をプロット
nl_plot(deriv_df = deriv_all, type = "curvature")
予測値の曲線と傾きを並べてプロット
曲がり方(二次微分)をプロット
<おすすめのRに関する書籍です>
この記事が誰かの役に立ちますように。